Diplomatura en Data Engineer
Construí la infraestructura de datos que sostiene toda organización moderna. SQL y modelado dimensional, pipelines, dbt, Spark, Airflow y cloud. Certificación IDSA + UTN.
Sobre esta Diplomatura
La Diplomatura en Data Engineer forma profesionales capaces de diseñar, construir y mantener la infraestructura que sostiene el análisis, el ML y la IA en una organización moderna. Pipelines, warehouses, procesamiento distribuido, orquestación y despliegue en cloud.
El foco es la producción, no el notebook. El alumno aprende a mover datos a escala: modelado dimensional, pipelines ETL/ELT en capas, procesamiento distribuido con Spark, orquestación con Airflow, transformación con dbt y despliegue sobre cloud. Cada curso tiene entregables que pasan o no pasan.
Es una de las trayectorias mejor pagas del observatorio IDSA (mediana senior de $4,2M ARS brutos mensuales, segunda entre los seis roles relevados), y todas las empresas que usan datos necesitan Data Engineers.
Se apoya en el tutor virtual 24/7 y en entornos de práctica accesibles desde el navegador. No requiere experiencia previa en ingeniería, pero sí rigor técnico.
Cuatro etapas hacia la ingeniería de datos
Cada etapa suma una capa: del acceso y el modelado de los datos a la transformación, la escala y el despliegue en cloud.
Python, Linux, Git y Docker, SQL y SQL avanzado con modelado dimensional. Las competencias base para trabajar con datos y diseñar modelos analíticos en cualquier organización.
Ingesta batch, capas bronze/silver/gold, transformación con dbt, procesamiento distribuido con Spark y orquestación con Airflow. El núcleo operativo del Data Engineer.
Despliegue de pipelines y almacenamiento en cloud: cómputo, almacenamiento y servicios gestionados para datos.
Un pipeline completo desde la fuente hasta el warehouse, con orquestación, transformación con dbt, procesamiento con Spark y despliegue en cloud.
Qué vas a aprender, curso por curso
Cada curso se cursa y certifica de forma individual. Al aprobar los ocho más el trabajo final, se emite el diploma de la diplomatura.
Python para Data Science
Del primer script al primer dashboard. Pandas, NumPy, Matplotlib y Dash. Los 4 verbos fundamentales de Pandas y la conexión con el análisis de negocio.
Linux, Git y Docker para Datos
Terminal de Linux y scripts de bash, Git y GitHub con pull requests, entornos de Python reproducibles y contenedores con Docker y Docker Compose, cerrando con un repositorio que cualquiera puede clonar y ejecutar.
SQL para Data Science
El lenguaje universal de los datos. SELECT, JOINs, agregaciones, subconsultas y window functions. Análisis de cohortes, retención y funnels sobre datasets reales.
SQL Avanzado y Modelado Dimensional
Ventanas avanzadas y CTEs recursivas, lectura de planes de ejecución y diseño de un modelo dimensional en estrella para un data mart.
Data Engineering Fundamentals
Del CSV crudo al pipeline observable: ingesta batch, capas bronze/silver/gold, orquestación con DAGs (construís tu propio orquestador), validaciones de calidad y observabilidad, sobre un caso real de Fintora.
dbt y Analytics Engineering
El puente entre análisis e ingeniería: modelado dimensional (Kimball) con dbt, testing automático, documentación, linaje y CI/CD aplicado al data warehouse.
Procesamiento Distribuido con Spark y Orquestación con Airflow
DataFrames y Spark SQL, particiones, shuffle y broadcast, y DAGs de Airflow con reintentos, backfills e idempotencia. Cierra con un pipeline batch de punta a punta.
Cloud para ML y Datos
Fundamentos de cloud aplicados a datos y ML: cómputo, almacenamiento, redes, IAM, servicios gestionados y buenas prácticas de despliegue en AWS, GCP y Azure.
Tres orientaciones en ingeniería de datos
La orientación se define por el trabajo final y el énfasis en cada componente del stack.
Data Engineer
Diseño y operación de pipelines ETL/ELT. El rol más demandado en empresas con datos a escala.
Cloud Data Engineer
Despliegue de pipelines y servicios de datos sobre infraestructura cloud, con entornos reproducibles.
Analytics Engineer
Puente entre datos y análisis. Modelado en dbt y construcción de la capa semántica.
Los perfiles son orientativos. El alumno construye su especialización con el trabajo final y los proyectos del Laboratorio de Datos.
Pipeline productivo end-to-end
Un proyecto integrador que cubre el ciclo completo: ingesta desde una fuente real, almacenamiento, transformación con dbt y Spark, orquestación con Airflow y despliegue en cloud. Incluye documentación técnica y defensa ante comité.
- Duración: 17 horas distribuidas en 4-6 semanas
- Tutoría personalizada durante todo el desarrollo
- Defensa oral ante comité técnico
- Publicación en el Laboratorio de Datos del Instituto
Doble aval universitario
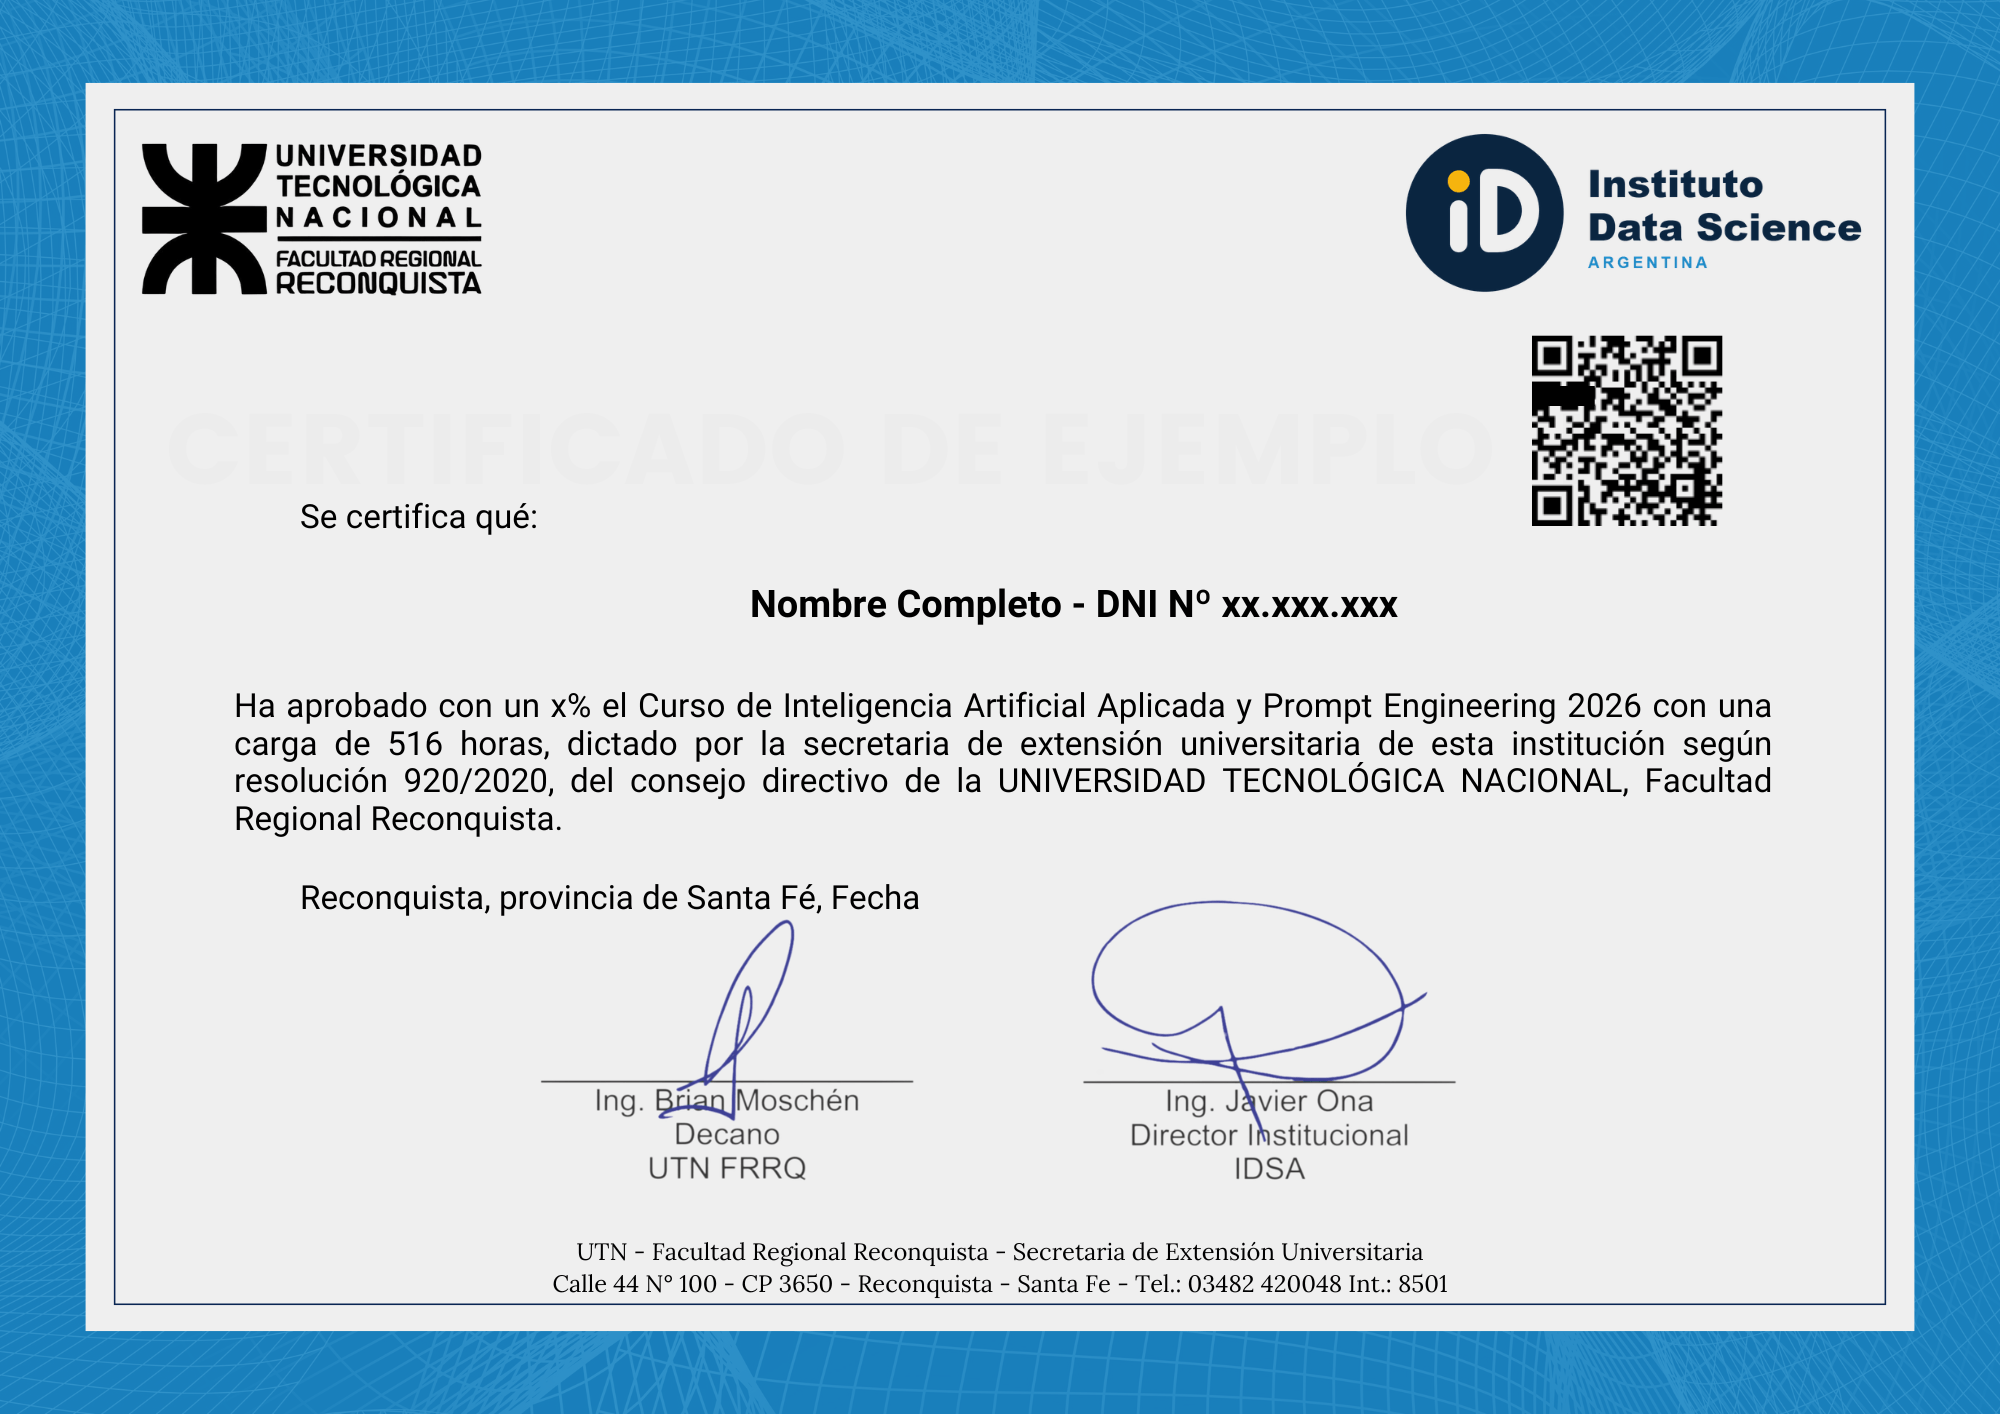
Certificación IDSA + UTN con resolución oficial y verificación digital de cada curso aprobado.
Qué incluye la certificación
- Diploma final con doble firma (Director IDSA + Decano UTN FRRQ)
- Certificado por cada curso completado en el camino
- Resolución oficial 920/2020 UTN Facultad Regional Reconquista
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Acreditación progresiva: cada curso completado ya queda certificado
Los certificados se emiten al aprobar los quizzes y trabajos prácticos de cada curso.
¿Diplomatura o cursos sueltos?
| Aspecto | Curso suelto | Diplomatura completa |
|---|---|---|
| Duración por unidad | 15-30h por curso | 197h totales |
| Certificación | IDSA + UTN por curso | IDSA + UTN por curso + diploma final |
| Trabajo final aplicado | — | ✓ Obligatorio |
| Publicación en Laboratorio | — | ✓ Elegible |
| Stack completo de ingeniería | Parcial | ✓ SQL + dbt + Spark + Airflow + Cloud |
| Pipeline productivo en cloud | Parcial | ✓ Cloud en Etapa 3 y proyecto en Etapa 4 |
Dudas sobre la Diplomatura
¿Necesito experiencia previa en ingeniería?
No. La trayectoria arranca desde los fundamentos de Python y SQL. Solo se requiere matemática de secundaria y ganas de aprender.
¿Qué herramientas voy a usar?
Python, PostgreSQL, DuckDB, dbt Core, Parquet, Apache Spark, Apache Airflow, Docker y servicios de cloud (AWS, GCP o Azure según el curso). Todo con notebooks y entornos accesibles desde el navegador, salvo Linux, Git y Docker y la parte de Airflow, que se ejecutan en tu computadora.
¿Necesito instalar algo en mi computadora?
En la mayoría de los cursos no: los entornos de práctica se ejecutan en la nube o en el navegador. La excepción es Linux, Git y Docker para Datos, y la parte de Airflow del curso de Spark y Airflow, que se practican en tu computadora y requieren una terminal, Git y Docker (el campus incluye la guía de instalación).
¿Cuánto tiempo lleva completarla?
A 10 horas semanales: aproximadamente 20 semanas (5 meses). A 6 horas semanales: unos 8 meses. El ritmo lo definís vos.
¿Cómo se cursan los cursos de la diplomatura?
Cada curso se cursa y se paga de forma individual. Podés comprarlos a medida que avanzás. Al aprobar los 8 cursos más el trabajo final, se emite el diploma de la diplomatura.
¿Qué diferencia hay con la Diplomatura en Analytics Engineer?
Data Engineer cubre la cadena completa de datos: ingesta, procesamiento distribuido con Spark, orquestación con Airflow, transformación con dbt y despliegue en cloud. Analytics Engineer se enfoca en la capa de transformación y modelado (dbt) sobre un warehouse ya existente. Si querés construir los pipelines de punta a punta, Data Engineer. Si querés especializarte en la capa semántica, Analytics Engineer.
¿Y streaming, calidad de datos y arquitectura?
Streaming de Datos, Calidad, Catálogo y Linaje de Datos y Arquitectura de Datos y Data Mesh están disponibles como cursos sueltos y forman parte de la Diplomatura en Data Architect, el paso natural después de esta.
¿Y si quiero reforzar la base matemática?
La Nivelación Matemática no integra esta diplomatura, pero podés cursarla por separado si querés reforzar la base antes de empezar o si pensás seguir hacia Machine Learning.
¿Qué industrias demandan este perfil?
Bancos, fintech, retail, telecomunicaciones, salud, gobierno y cualquier organización con volúmenes de datos relevantes. También empresas de tecnología y consultoras de datos.
¿Qué puedo cursar después?
La Diplomatura en Data Architect, con acreditación directa de los siete cursos que comparte con esta (Python, Linux, Git y Docker, SQL, SQL Avanzado, Data Engineering Fundamentals, Spark y Airflow, y Cloud), o la Diplomatura en ML Engineer, que comparte Python, SQL, Data Engineering Fundamentals y Cloud.
Construí la infraestructura de los datos
197 horas con foco en Linux, Git y Docker, pipelines, Spark, Airflow, dbt y cloud. Trabajo final de pipeline productivo y doble certificación IDSA + UTN.