dbt y Analytics Engineering
Dominá dbt de cero a producción: modelado dimensional, tests automáticos, documentación, modelos incrementales, snapshots SCD2, macros Jinja y CI/CD con GitHub Actions. Todo sobre un caso real de Fintora.
with staging as (
select * from {{ ref(‘stg_ventas’) }}
)
select
{{ dbt_utils.surrogate_key(…) }} as sk,
*
from staging
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables con corrección automática. Sin ambigüedades, sin autoevaluación subjetiva.
Comprender el rol del Analytics Engineer en un equipo de datos moderno
Instalar y configurar un proyecto dbt desde cero
Modelar datos siguiendo el enfoque dimensional (Kimball) en dbt
Aplicar las convenciones de staging, intermediate y marts
Escribir tests automáticos (schema tests + data tests)
Documentar modelos, columnas y fuentes con dbt docs
Implementar modelos incrementales para datasets grandes
Diseñar snapshots para capturar cambios históricos (SCD Type 2)
Escribir macros reutilizables y usar packages de la comunidad
Automatizar testing y despliegue con GitHub Actions
Comprender el lineage y la observabilidad de datos
Presentar un proyecto dbt completo ante stakeholders técnicos
10 unidades · 2 horas cada una
Progresión estructurada: del diagnóstico del caos SQL al proyecto integrador con un modelo completo para Fintora.
- Comprender los síntomas de un equipo sin capa de transformación
- Mapear las fuentes de datos, queries y reportes existentes
- Identificar los riesgos de negocio que genera el SQL suelto
- Instalar y configurar un proyecto dbt desde cero
- Comprender la estructura de carpetas y archivos de configuración
- Escribir los primeros modelos SQL con la convención de staging
- Diseñar un star schema con dbt
- Escribir modelos de hechos y dimensiones
- Comprender granularidad y claves surrogate
- Escribir tests de schema (uniqueness, not_null, relationships, accepted_values)
- Escribir tests de datos custom (singular tests)
- Integrar los tests en el flujo de desarrollo
- Documentar modelos, columnas y fuentes con dbt
- Generar y navegar dbt docs
- Comprender el lineage y cómo se usa en debugging
- Comprender cuándo usar modelos incrementales
- Implementar estrategias incremental, merge y delete+insert
- Manejar late-arriving data y reprocesamiento
- Comprender Slowly Changing Dimensions y sus tipos
- Implementar snapshots en dbt
- Consultar snapshots para análisis histórico
- Escribir macros reutilizables en Jinja
- Usar packages de la comunidad
- Aplicar DRY (Don’t Repeat Yourself) a los modelos dbt
- Comprender los entornos de desarrollo, staging y producción
- Automatizar testing en cada pull request
- Desplegar a producción con confianza
- Integrar todos los conocimientos en un proyecto dbt completo
- Documentar decisiones y trade-offs con ADRs
- Presentar el proyecto ante stakeholders técnicos y de negocio
Diseñado para profesionales que modelan datos
100% autogestionado y asincrónico. Tutor virtual 24/7, notebooks ejecutables en JupyterLite o Google Colab, entregables verificables y defensa conversacional.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso responde tus dudas de forma clara y directa, sin abrumar con citas extensas.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Contenido en Moodle
Lecciones estructuradas y referenciadas en texto. Sin videos interminables: leé, consultá y avanzá a tu ritmo.
- Plataforma Moodle
- Búsqueda instantánea
- Ritmo personal
Notebooks ejecutables
Notebooks con SQL, Jinja y dbt reales. Cada concepto de Analytics Engineering se implementa sobre un proyecto dbt funcional.
- JupyterLite o Colab
- Código paso a paso
- Proyecto dbt real
Entregables con defensa conversacional
Cada unidad tiene entregables obligatorios con verificación automática y defensa conversacional para validar tu comprensión.
- Corrección automática
- Defensa conversacional
- Feedback inmediato
Del SQL suelto al warehouse testeado
Un ciclo claro que parte del diagnóstico del caos y llega a un proyecto dbt productivo con CI/CD y documentación.
Diagnosticar
Entender el caos y priorizar por impacto.
Modelar
Staging, intermediate y marts en dbt.
Testear
Schema tests, data tests y docs.
Desplegar
CI/CD con GitHub Actions.
Herramientas que usarás
Todo se ejecuta con notebooks en JupyterLite o Google Colab, y repositorios de GitHub como base del proyecto dbt.
 dbt
 SQL
 Jinja
 GitHub Actions
 Snowflake
 BigQuery PostgreSQL
 GitHub
 JupyterLite
 Google Colab
 Moodle
Doble aval universitario, verificación digital
Al completar el curso recibís un certificado digital con doble aval: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
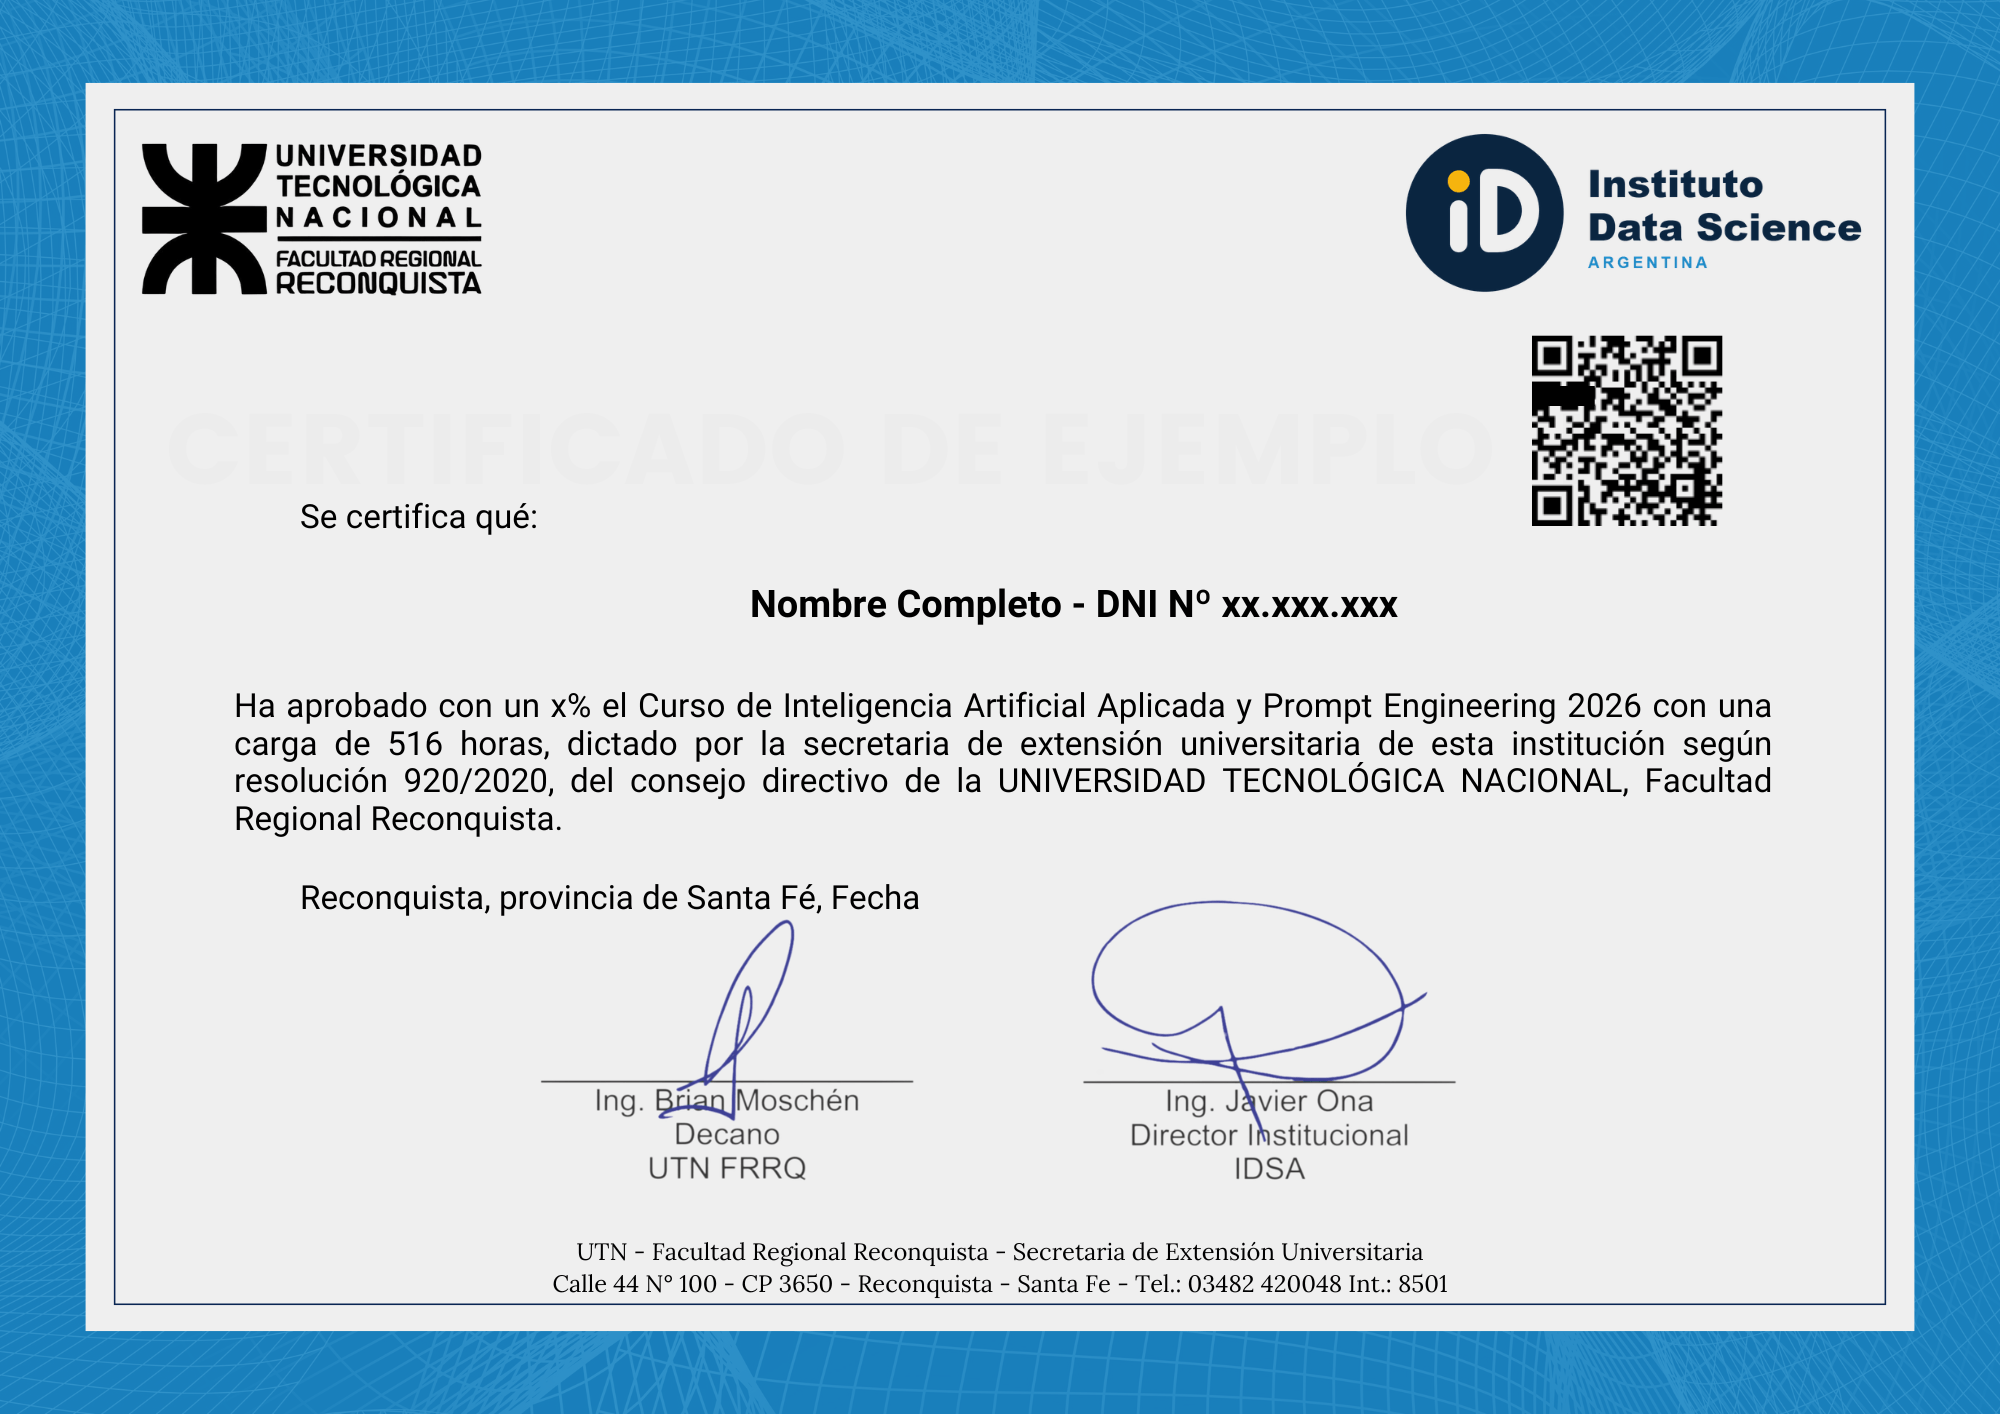
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
Del SQL suelto al warehouse testeado
10 unidades, 20 horas, con proyecto integrador end-to-end. Modelado Kimball, tests, docs y CI/CD con dbt.