Data Engineering Fundamentals
Dominá el ciclo completo de un pipeline de datos: ingesta batch, modelado en capas (bronze/silver/gold), orquestación con DAGs, validaciones de calidad y observabilidad. Todo sobre un caso real de Fintora.
def run(source):
bronze = ingest(source)
silver = clean(bronze)
gold = model(silver)
validate(gold)
return publish(gold)
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables con corrección automática. Sin ambigüedades, sin autoevaluación subjetiva.
Comprender el rol del Data Engineer y las arquitecturas de datos
Modelar datos en capas (bronze/silver/gold) y dimensionalmente
Implementar ingesta batch desde CSV, JSON y logs
Elegir formatos de almacenamiento según el caso de uso
Construir transformaciones idempotentes y reproducibles
Orquestar flujos con dependencias, retries y backfills
Aplicar validaciones de calidad de datos sistemáticas
Monitorear pipelines: frescura, volumen, esquema, linaje
Optimizar ingesta y transformación con criterio
Documentar pipelines y decisiones técnicas
10 unidades · 3 horas cada una
Progresión estructurada: del rol del Data Engineer al proyecto integrador con un pipeline end-to-end para Fintora.
- Comprender el rol del Data Engineer y su lugar en un equipo de datos
- Diferenciar arquitecturas batch, streaming y mixtas
- Identificar los componentes de una plataforma de datos moderna
- Comprender el modelado en capas (bronze/silver/gold)
- Aplicar modelado dimensional (hechos y dimensiones)
- Diseñar un modelo para Fintora fase 1
- Implementar ingesta batch desde CSV, JSON Lines y logs
- Manejar esquemas, tipos y evolución
- Detectar y aislar registros inválidos en la ingesta
- Elegir formatos de almacenamiento según el caso de uso
- Aplicar particionado y compresión con criterio
- Diseñar el layout del lake local de Fintora
- Implementar transformaciones idempotentes
- Limpiar y tipar datos de bronze a silver
- Construir el modelo dimensional en gold
- Comprender el concepto de DAG y orquestación
- Implementar un mini-orquestador en Python
- Manejar retries, backfills y fallos
- Diseñar validaciones de calidad sistemáticas
- Implementar tests sobre pipelines
- Definir contratos entre capas
- Implementar observabilidad básica sobre el pipeline
- Documentar linaje de datos
- Definir y monitorear SLAs de frescura
- Diagnosticar cuellos de botella en ingesta y transformación
- Aplicar técnicas de optimización con criterio
- Escalar el pipeline sin cambiar la lógica
- Integrar todos los conocimientos en un pipeline end-to-end
- Documentar decisiones arquitectónicas
- Presentar el pipeline y sus resultados a stakeholders
Diseñado para profesionales que construyen datos
100% autogestionado y asincrónico. Notebooks en JupyterLite o Google Colab y tutor virtual 24/7.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso responde tus dudas de forma clara y directa, sin abrumar con citas extensas.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Contenido en Moodle
Lecciones estructuradas y referenciadas en texto. Sin videos interminables: leé, consultá y avanzá a tu ritmo.
- Plataforma Moodle
- Búsqueda instantánea
- Ritmo personal
Notebooks en JupyterLite y Google Colab
Notebooks ejecutables con código real. Cada componente del pipeline se implementa y se ejecuta sobre datos reales.
- Ejecución sin configuración
- JupyterLite o Colab
- Pipeline funcional end-to-end
Entregables verificados
Cada unidad tiene entregables obligatorios con verificación automática. Sabés exactamente si el pipeline cumple o no cumple.
- Corrección automática
- Criterios objetivos
- Feedback inmediato
Del CSV crudo al pipeline observable
Un ciclo claro que parte del rol del Data Engineer y llega a un pipeline end-to-end testeado, monitoreado y documentado.
Diseñar
Arquitectura, capas y modelo dimensional.
Ingestar
Batch desde CSV, JSON y logs.
Transformar
Bronze → silver → gold, idempotente.
Observar
Calidad, linaje, frescura y optimización.
Herramientas que usarás
Sin instalación local. Todo se ejecuta en JupyterLite o Google Colab.
 Python
 Pandas
 PyArrow
 SQL
 DuckDB
 JupyterLite
 Google Colab
 Moodle
Doble aval universitario, verificación digital
Al completar el curso recibís un certificado digital con doble aval: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
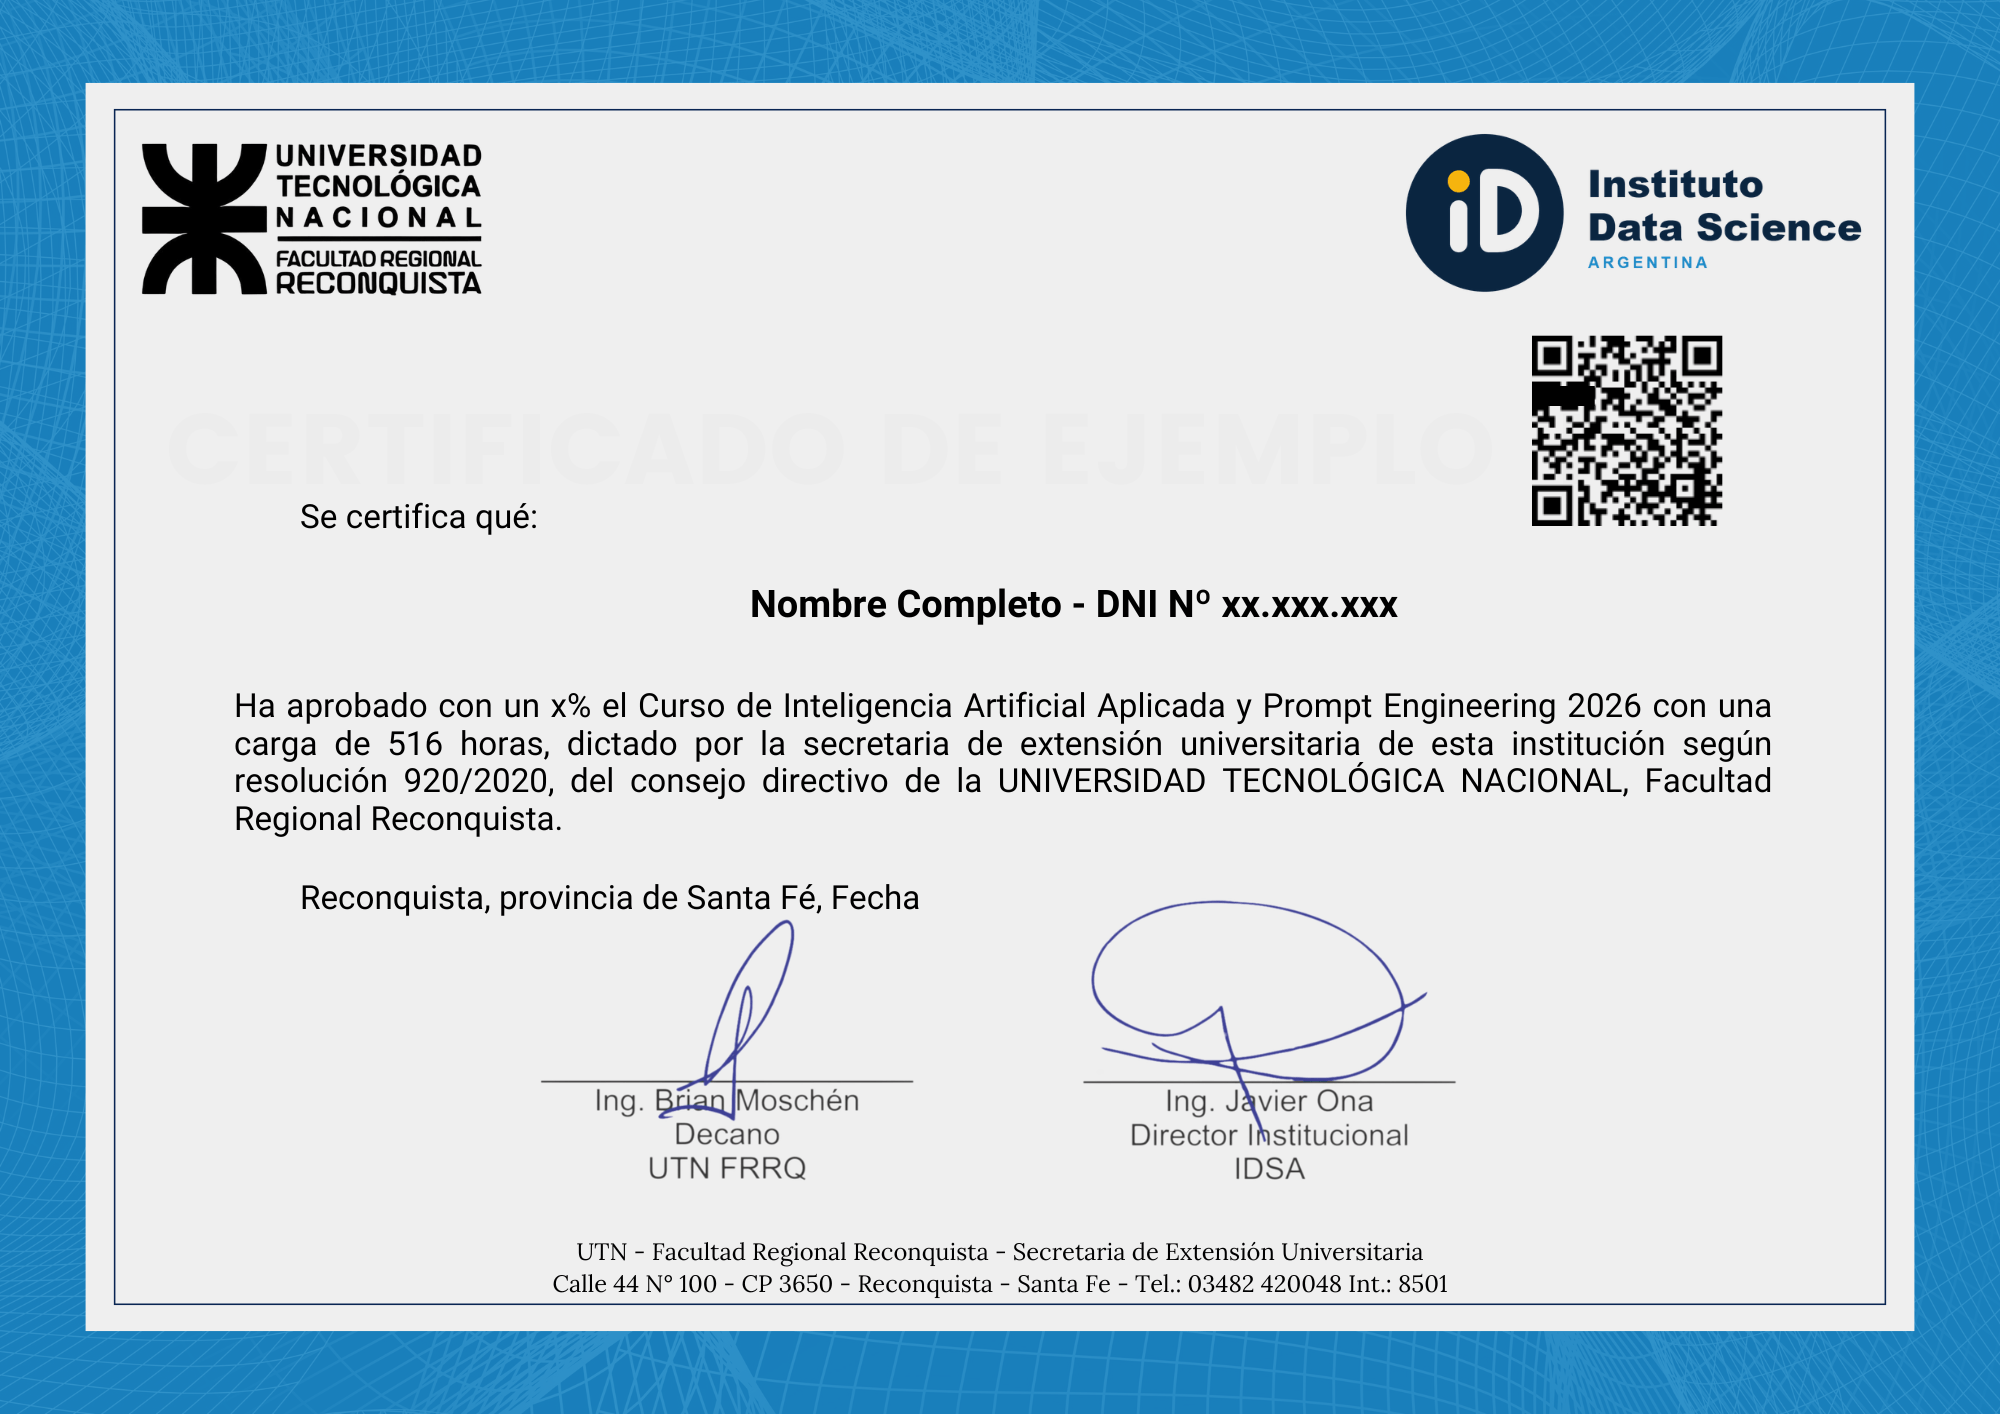
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
Del CSV crudo al pipeline observable
10 unidades, 30 horas, con proyecto integrador end-to-end. Ingesta, capas, orquestación y calidad.