OpenAI Navier-Stokes: qué pasó con la prueba y la polémica
OpenAI Navier-Stokes: así se resume la noticia de IA más comentada de septiembre de 2026. En diez días, OpenAI anunció que un modelo había resuelto un problema matemático abierto desde hace casi un siglo. Después, un matemático de la Universidad de Nueva York los acusó de jugar sucio. Y esta semana, 25 ganadores de la Medalla Fields firmaron una carta abierta contra la forma en que los laboratorios de IA hacen matemática.
Si seguiste nuestras redes ya viste partes de esta historia. Acá la contamos completa: qué está confirmado, qué está en disputa y qué todavía nadie sabe.
Qué es el problema de Navier-Stokes
Las ecuaciones de Navier-Stokes describen cómo se mueven los fluidos. Explican el aire sobre el ala de un avión, el agua en una tubería o el humo de un café. Se formularon en el siglo XIX y se usan todos los días en ingeniería y meteorología. En otras palabras, funcionan.
Sin embargo, nadie pudo demostrar en 200 años algo más profundo. ¿Sus soluciones en tres dimensiones se mantienen siempre «suaves»? ¿O pueden volverse infinitas en un tiempo finito? Los matemáticos llaman a eso una singularidad. En el año 2000, el Clay Mathematics Institute incluyó esta pregunta entre sus siete Problemas del Milenio y ofreció un millón de dólares por resolverla.
Un detalle que importa: el enunciado oficial tiene cuatro variantes. Dos tratan las ecuaciones sin fuerzas externas, y la comunidad suele considerarlas «el» problema. Las otras dos permiten un forzamiento externo, y muchos las consideran más accesibles.
Qué anunció OpenAI sobre Navier-Stokes
El 8 de septiembre, OpenAI publicó que un modelo interno, todavía no lanzado, había producido una prueba analítica. Según la empresa, la prueba muestra que en las ecuaciones en 3D puede ocurrir una singularidad en tiempo finito. Además, la construyeron miles de instancias del modelo trabajando en paralelo durante 88 horas. Luego, la verificaron formalmente con Lean, un asistente de demostración, en unas 17 horas más.
Los números del esfuerzo son parte de la noticia. OpenAI informó que el trabajo consumió unos 300.000 millones de tokens de salida. A las tarifas actuales de su modelo Astra, eso equivale a unos 22,5 millones de dólares de cómputo. Para un premio de un millón. La empresa aclaró, de todos modos, que no piensa reclamarlo.
El mismo comunicado dice que el proyecto arrancó el 1 de septiembre, motivado por rumores de que dos Problemas del Milenio estaban por resolverse. Esa fecha es el centro de la controversia que vino después.
Por qué la prueba de OpenAI no resuelve Navier-Stokes
Qué probó y qué no
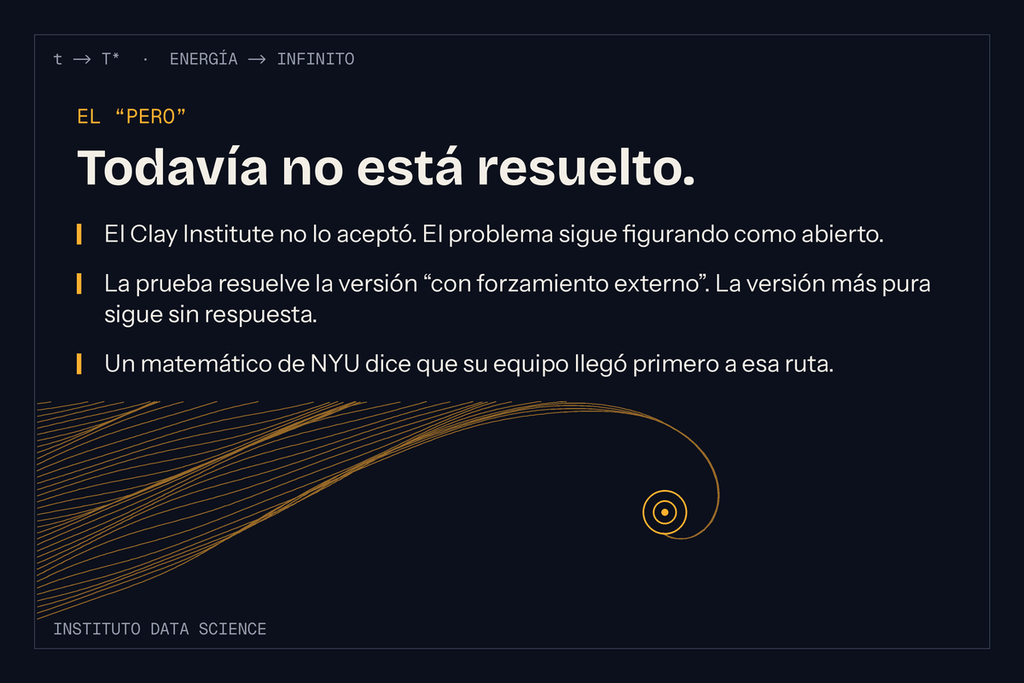
La prueba aborda las variantes con forzamiento externo del enunciado oficial. Las versiones sin forzamiento, que buena parte de la comunidad considera la pregunta central, siguen abiertas. Por lo tanto, es un resultado importante si se confirma. Pero no es «Navier-Stokes resuelto» en el sentido que la mayoría entendió por los titulares.
Quién lo verificó
Nadie fuera de OpenAI, todavía. La verificación con Lean garantiza que los pasos lógicos son consistentes con sus premisas. Sin embargo, no reemplaza la revisión de pares, que evalúa si el problema planteado es el correcto y si el resultado aporta ideas nuevas. De hecho, el Clay Institute no aceptó el anuncio y sigue listando el problema como abierto.
El estándar de la disciplina
En matemática, un resultado existe cuando otros pueden leerlo, entenderlo y reproducirlo. Un anuncio sin escritura completa, sin aislar las ideas nuevas y sin diálogo con quienes trabajaban en el mismo problema no cumple ese estándar. Por más impresionante que sea.
La acusación del matemático de NYU
Dos días después del anuncio, Tristan Buckmaster, profesor de matemática en la Universidad de Nueva York, contó su versión. Trabajaba junto con Levent Alpöge, un matemático de Anthropic que participó a título personal. Entre los dos venían desarrollando tres pruebas relacionadas y un resultado preliminar sobre el mismo problema. Para eso usaron tanto Codex, de OpenAI, como modelos Claude, de Anthropic.
Según Buckmaster, mientras terminaban de escribir se enteraron de que información sobre su avance había llegado a OpenAI. Cuando consultaron, la empresa respondió que ya tenía una prueba completa. Pero cuando preguntaron cuándo habían empezado, dice, las respuestas se volvieron evasivas. Al final, se reconoció que el primer prompt se había enviado pocos días antes, después de que la información circulara. También acusó a OpenAI de presionarlo para no darle crédito a su colaborador.
OpenAI negó todo. Sébastien Bubeck, que dirige la investigación matemática de la empresa, calificó las acusaciones de falsas. Además, dijo que entró en la conversación siguiendo las normas académicas habituales. La publicación oficial confirma que hubo conversaciones con Buckmaster y Alpöge. Sostiene, también, que no vieron el trabajo de ellos hasta que se hizo público y que no se accedió a datos de ningún usuario en particular.
Pero incluye una frase que la comunidad no dejó pasar. La empresa admite que no puede descartar que datos desidentificados del uso de sus productos hayan ayudado a mejorar sus modelos. Dicho en simple: OpenAI dice que no copió. Al mismo tiempo, reconoce que no puede garantizar que lo que los matemáticos escribieron en Codex no haya terminado entrenando al sistema que compitió con ellos.
La carta de los 25 medallistas Fields
El 11 de septiembre se publicó una carta abierta firmada por 25 matemáticos, todos ganadores de la Medalla Fields. Es difícil exagerar el peso de ese grupo. La Fields se entrega cada cuatro años a un puñado de personas menores de 40 años. Reunir a 25 medallistas en un mismo documento casi nunca pasa.
La carta no discute si la prueba de OpenAI es correcta. Discute cómo se está haciendo la investigación. Sus puntos centrales, en nuestras palabras, son estos:
- Los resultados se anuncian a las apuradas, sin escritura formal, sin aislar las ideas nuevas y sin citar el trabajo previo. Eso abre preguntas de atribución y plagio, como en cualquier profesión creativa.
- El cómputo cambia los incentivos. Si un laboratorio detecta un camino prometedor, puede gastar decenas de millones para llegar antes. La consecuencia es el secreto: nadie va a querer contar en qué trabaja.
- Las herramientas son también un canal. Varios matemáticos ya se preguntan si su uso de Codex alimentó a los modelos que ahora compiten con ellos.
- Esto no es solo de la matemática. La carta cierra con una advertencia a otras disciplinas: lo que hoy les pasa a ellos le va a pasar al resto.
El mismo día, OpenAI retiró el patrocinio de un evento de matemática en Caltech, después de críticas de investigadores de esa universidad. Y no es la primera señal. En junio, un grupo de matemáticos ya había publicado la Declaración de Leiden, con recomendaciones para convivir con las pruebas producidas por IA.
El contexto que explica el apuro
Nada de esto ocurre en el vacío. El 3 de septiembre, OpenAI lanzó GPT-6 Astra y lo presentó como el inicio de la «era AGI». Una semana después, tuvo que pausar las altas nuevas a su plan Pro porque la demanda superó su infraestructura. Un anuncio como «resolvimos un problema del milenio» en medio de ese lanzamiento no es un accidente de calendario.
Conviene decirlo sin cinismo. Es posible que la prueba sea correcta, que el modelo sea extraordinario y que, aun así, la forma de anunciarlo haya sido mala para la ciencia. Las tres cosas pueden ser verdad al mismo tiempo.
Qué nos enseña el caso OpenAI Navier-Stokes a quienes trabajamos con datos
Desde el Instituto seguimos esta historia con atención porque toca tres cosas que enseñamos todos los días.
Verificar no es un trámite. Una prueba formalizada en Lean parece el final del camino, pero es el principio. Lo mismo pasa con un modelo con buena métrica o un dashboard prolijo. Hasta que alguien independiente lo revisa, es una hipótesis con buena presentación.
Atribuir es parte del trabajo. En ciencia de datos usamos código, datasets y modelos de otros. Saber de dónde viene cada pieza y decirlo no es cortesía académica. Es lo que hace que el trabajo sea auditable y que otros puedan construir sobre él.
Lo que escribís en una herramienta no siempre se queda ahí. Saber qué compartís, con qué modelo y bajo qué condiciones es hoy una competencia profesional básica. Por eso, en nuestro Curso de Inteligencia Artificial Aplicada y Prompt Engineering dedicamos tiempo no solo a escribir mejores instrucciones, sino a entender qué pasa con ellas.
La pregunta que dejó abierta el caso OpenAI Navier-Stokes no es si la IA puede hacer matemática. Ya sabemos que puede. La pregunta es de quién es un descubrimiento cuando lo hace una máquina, y quién lo revisa. Esa respuesta no va a salir de un laboratorio. Va a salir de la gente que entiende cómo funcionan estas herramientas y decide, con criterio, cómo usarlas. Si querés ser parte de esa gente, conocé nuestros cursos.
Fuentes consultadas
- TechCrunch, 8 de septiembre de 2026: OpenAI fought dirty on career-making math problem, says NYU mathematician.
- TechCrunch, 11 de septiembre de 2026: OpenAI’s feud with mathematicians is only escalating.
- Carta abierta de los 25 medallistas Fields: mathandai.org.