Visión por Computadora Avanzada
Llevá la visión por computadora más allá de las CNN: Vision Transformers, aprendizaje autosupervisado y embeddings, modelos visión-lenguaje como CLIP, difusión para imágenes y análisis de video. Terminás con un buscador visual de productos construido y evaluado de punta a punta.
model, preprocess = open_clip.create_model_and_transforms(
“ViT-B-32”, pretrained=“laion2b_s34b_b79k”)
emb = model.encode_image(batch)
sims = emb @ query.T
De las CNN a los modelos fundacionales de visión
Cada objetivo es verificable mediante entregables y defensa conversacional. Vas a poder elegir, adaptar y evaluar arquitecturas modernas de visión, y justificar cada decisión.
Explicar cómo un Vision Transformer procesa una imagen y cuándo conviene frente a una CNN
Hacer fine-tuning de un ViT sobre un dataset propio y comparar con una CNN
Obtener embeddings visuales autosupervisados y usarlos para búsqueda por similitud
Usar CLIP para clasificación zero-shot y búsqueda imagen-texto, y analizar sus errores
Generar y controlar imágenes con difusión latente, ControlNet y LoRA
Construir y evaluar un buscador visual de punta a punta con defensa conversacional
6 unidades · 30 horas
Cada unidad incluye lecciones, un quiz de corrección automática y un entregable en un notebook de Google Colab.
- Imágenes como secuencias de parches; atención aplicada a visión
- ViT y Swin frente a las CNN: datos, costo y precisión
- Fine-tuning de un ViT sobre un dataset propio
- Aprendizaje contrastivo y SimCLR
- DINOv2 y embeddings de propósito general
- Búsqueda por similitud y linear probing
- Aprendizaje contrastivo imagen-texto con CLIP
- Clasificación zero-shot y búsqueda imagen-texto
- Captioning y respuesta a preguntas sobre imágenes; análisis de errores
- De la difusión a la difusión latente: Stable Diffusion
- Sampling y classifier-free guidance
- Control con ControlNet y adaptación con LoRA
- Seguimiento por detección y asociación de objetos entre cuadros
- Flujo óptico y movimiento
- Clasificación de acciones con modelos de video
- Buscador visual de productos: embeddings, índice de similitud y consulta por texto
- Evaluación con métricas de recuperación y análisis de errores
- Informe técnico y defensa conversacional
- 10 preguntas al azar de un banco de 20 · 40 minutos · 2 intentos
- Se aprueba con 6 sobre 10
- Aprobarlo habilita el certificado
Diseñado para profesionales que practican
100% autogestionado y asincrónico. Cada unidad incluye lecciones, un quiz y un entregable en Google Colab con controles automáticos y defensa conversacional.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso resuelve tus dudas y evalúa tu comprensión mediante defensa conversacional.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Lecciones en texto
Contenido estructurado en el campus, con la matemática justa y ejemplos paso a paso. Leé, consultá y avanzá a tu ritmo.
- Ejemplos paso a paso
- Búsqueda instantánea
- Ritmo personal
Notebooks en Google Colab
Notebooks ejecutables con código real y GPU disponible. No pseudocódigo: cada modelo se carga, se adapta y se evalúa.
- Sin instalación
- GPU disponible
- Código paso a paso
Entregables con defensa conversacional
Cada unidad tiene un entregable con controles automáticos y una defensa conversacional. Recibís feedback sobre tu trabajo y tus decisiones.
- Controles automáticos
- Defensa conversacional
- Criterios claros
De la arquitectura al sistema, con evaluación
Cada técnica se explica, se ejecuta sobre imágenes reales y se evalúa antes de pasar a la siguiente.
Entender
La arquitectura y su razón de ser.
Adaptar
Fine-tuning y embeddings.
Evaluar
Métricas y análisis de errores.
Integrar
Un sistema visual completo.
Herramientas que usarás
Sin fricción de configuración. Todo se ejecuta en Google Colab con GPU.
 Python
 PyTorch
 Hugging Face
 OpenCV
 Google Colab
Doble aval universitario, verificación digital
Al aprobar el curso descargás tu certificado desde el campus y podés tramitar la homologación del certificado oficial: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
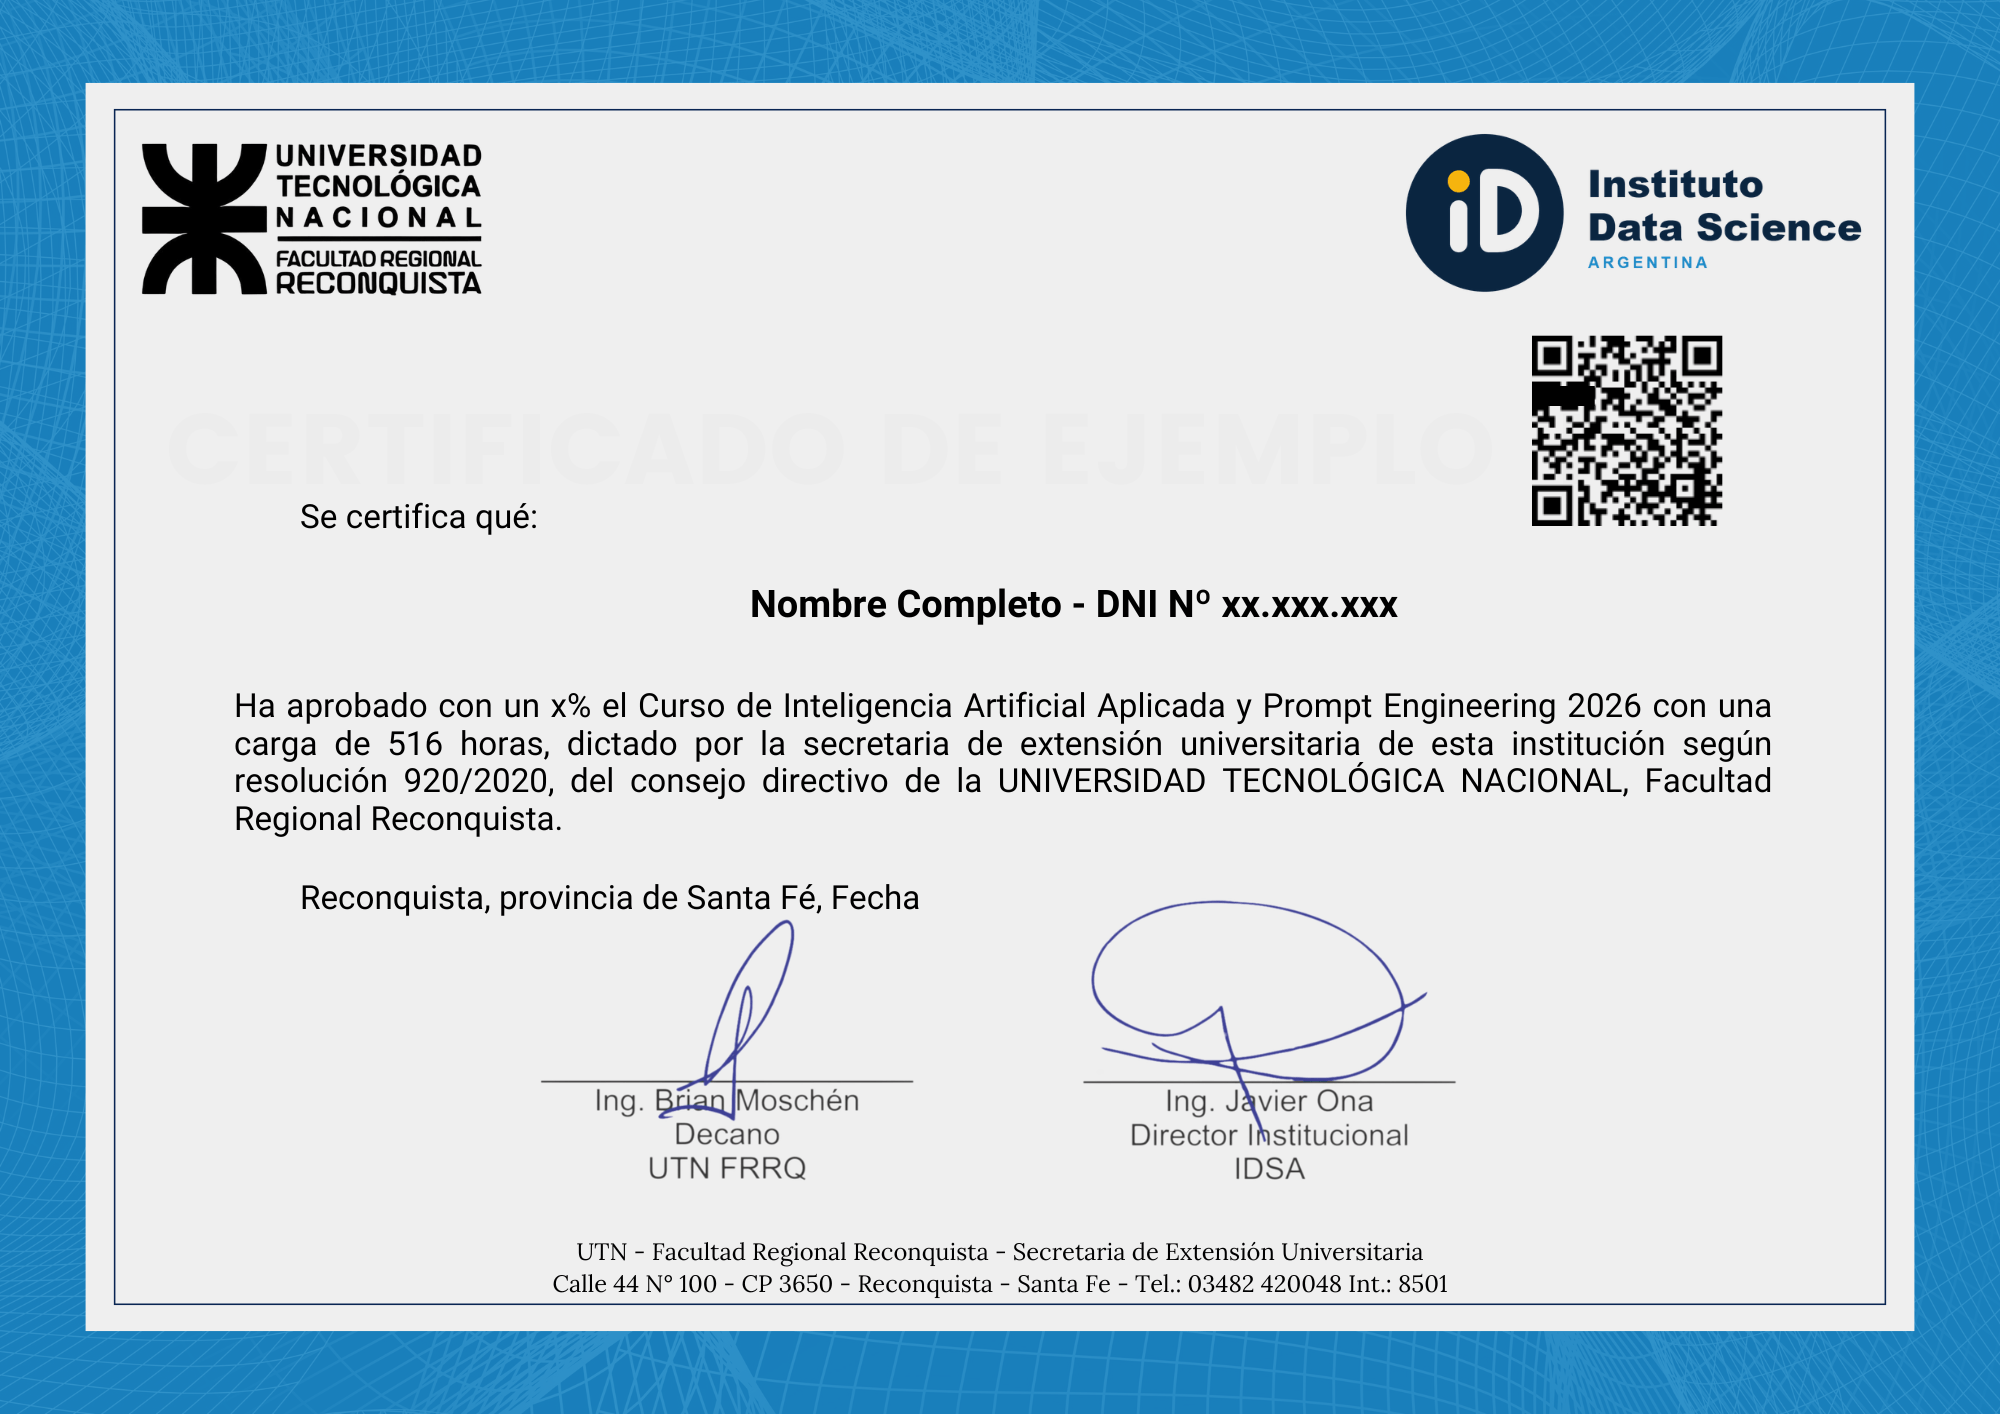
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Homologación a pedido: enviás el certificado del campus y tu DNI a info@institutodatascience.org y recibís el certificado oficial por correo
- Emisión por curso: no esperás al final del trayecto
Se habilita al aprobar el Examen Final del curso (nota mínima 6 sobre 10).
Resolvemos tus dudas
De la imagen al sistema visual completo
6 unidades, 30 horas, verificable y aplicable. Con un buscador visual de productos y certificación IDSA + UTN.