NLP Avanzado con Transformers
Diseñá, construí y desplegá pipelines de NLP productivos con transformers. Dominá tokenización, embeddings, clasificación, NER, fine-tuning eficiente con LoRA, evaluación con calibración y serving optimizado.
from transformers import pipeline
clf = pipeline(“text-classification”,
model=“dccuchile/bert-base-spanish”)
feat = clf(text, top_k=3)
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables con corrección automática. Sin ambigüedades, sin autoevaluación subjetiva.
Diseñar, construir y desplegar pipelines de NLP productivos usando transformers
Comprender el pipeline de NLP end-to-end: de texto crudo a feature utilizable en modelos tabulares
Comparar representaciones de texto: TF-IDF, word embeddings y embeddings contextuales
Trabajar con transformers vía Hugging Face: clasificación, NER y fine-tuning
Evaluar modelos NLP con métricas apropiadas (F1 macro, calibración) y detectar sesgos
Integrar señales de texto en modelos tabulares de scoring crediticio
Documentar decisiones de modelado y evaluación con ADRs y model cards
10 unidades · 3 horas cada una
Progresión estructurada: del pipeline end-to-end al proyecto integrador con un pipeline NLP completo para Fintora.
- Comprender el flujo end-to-end de un pipeline NLP productivo
- Analizar un corpus de texto real en español y extraer métricas básicas
- Diferenciar tareas de NLP: clasificación, NER, QA, generación
- Comprender las representaciones clásicas: bag-of-words, TF-IDF
- Comprender los embeddings: word2vec, GloVe
- Comparar representaciones para tareas específicas
- Comprender la arquitectura transformer a nivel conceptual
- Cargar y usar un modelo pre-entrenado con Hugging Face
- Hacer inferencia sin fine-tuning
- Fine-tuning rápido de un transformer para clasificación
- Comprender el Trainer de Hugging Face
- Evaluar un modelo de clasificación correctamente
- Conocer los modelos pre-entrenados específicos para español
- Comparar modelos en tareas de clasificación reales
- Comprender los sesgos dialectales
- Comprender la tarea de NER
- Extraer entidades de textos financieros en español
- Entrenar un NER custom para el dominio
- Hacer fine-tuning con menos datos (few-shot)
- Comprender PEFT y LoRA a nivel conceptual
- Optimizar el fine-tuning para GPU limitada
- Evaluar modelos NLP más allá de accuracy
- Detectar sesgos y errores sistemáticos
- Comprender la calibración y su importancia
- Desplegar un modelo NLP como servicio
- Optimizar la inferencia: batch, cuantización, cache
- Integrar señales de NLP en un modelo tabular
- Integrar todos los conocimientos en un pipeline NLP completo
- Documentar decisiones con ADRs y diagramas C4
- Presentar el proyecto ante stakeholders técnicos y de negocio
Diseñado para profesionales que construyen con NLP
100% autogestionado y asincrónico. Notebooks en JupyterLite o Google Colab, tutor virtual 24/7, quizzes y entregables con defensa conversacional.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso responde tus dudas de forma clara y directa, sin abrumar con citas extensas.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Contenido en Moodle
Lecciones estructuradas y referenciadas en texto. Sin videos interminables: leé, consultá y avanzá a tu ritmo.
- Plataforma Moodle
- Búsqueda instantánea
- Ritmo personal
Notebooks en JupyterLite y Google Colab
Notebooks ejecutables con código real. Cada técnica de NLP se implementa y se ejecuta sobre modelos y datos reales.
- JupyterLite o Colab
- Código paso a paso
- Modelos desde Hugging Face Hub
Entregables con defensa conversacional
Cada unidad tiene entregables obligatorios con verificación automática y defensa conversacional para validar tu comprensión.
- Corrección automática
- Defensa conversacional
- Feedback inmediato
Del texto crudo a la decisión de negocio
Un ciclo claro que parte del pipeline end-to-end y llega a la integración de señales NLP en modelos tabulares de scoring.
Representar
Tokenización, TF-IDF y embeddings.
Modelar
Clasificación, NER y fine-tuning.
Evaluar
F1, calibración y sesgos.
Integrar
Señales NLP en modelo tabular.
Herramientas que usarás
Todo se ejecuta en JupyterLite o Google Colab con modelos descargables desde Hugging Face Hub.
 Python
 PyTorch
 Transformers Datasets Trainer PEFT / LoRA
 scikit-learn
 spaCy Hugging Face Hub
 Moodle
 JupyterLite
 Google Colab
Doble aval universitario, verificación digital
Al completar el curso recibís un certificado digital con doble aval: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
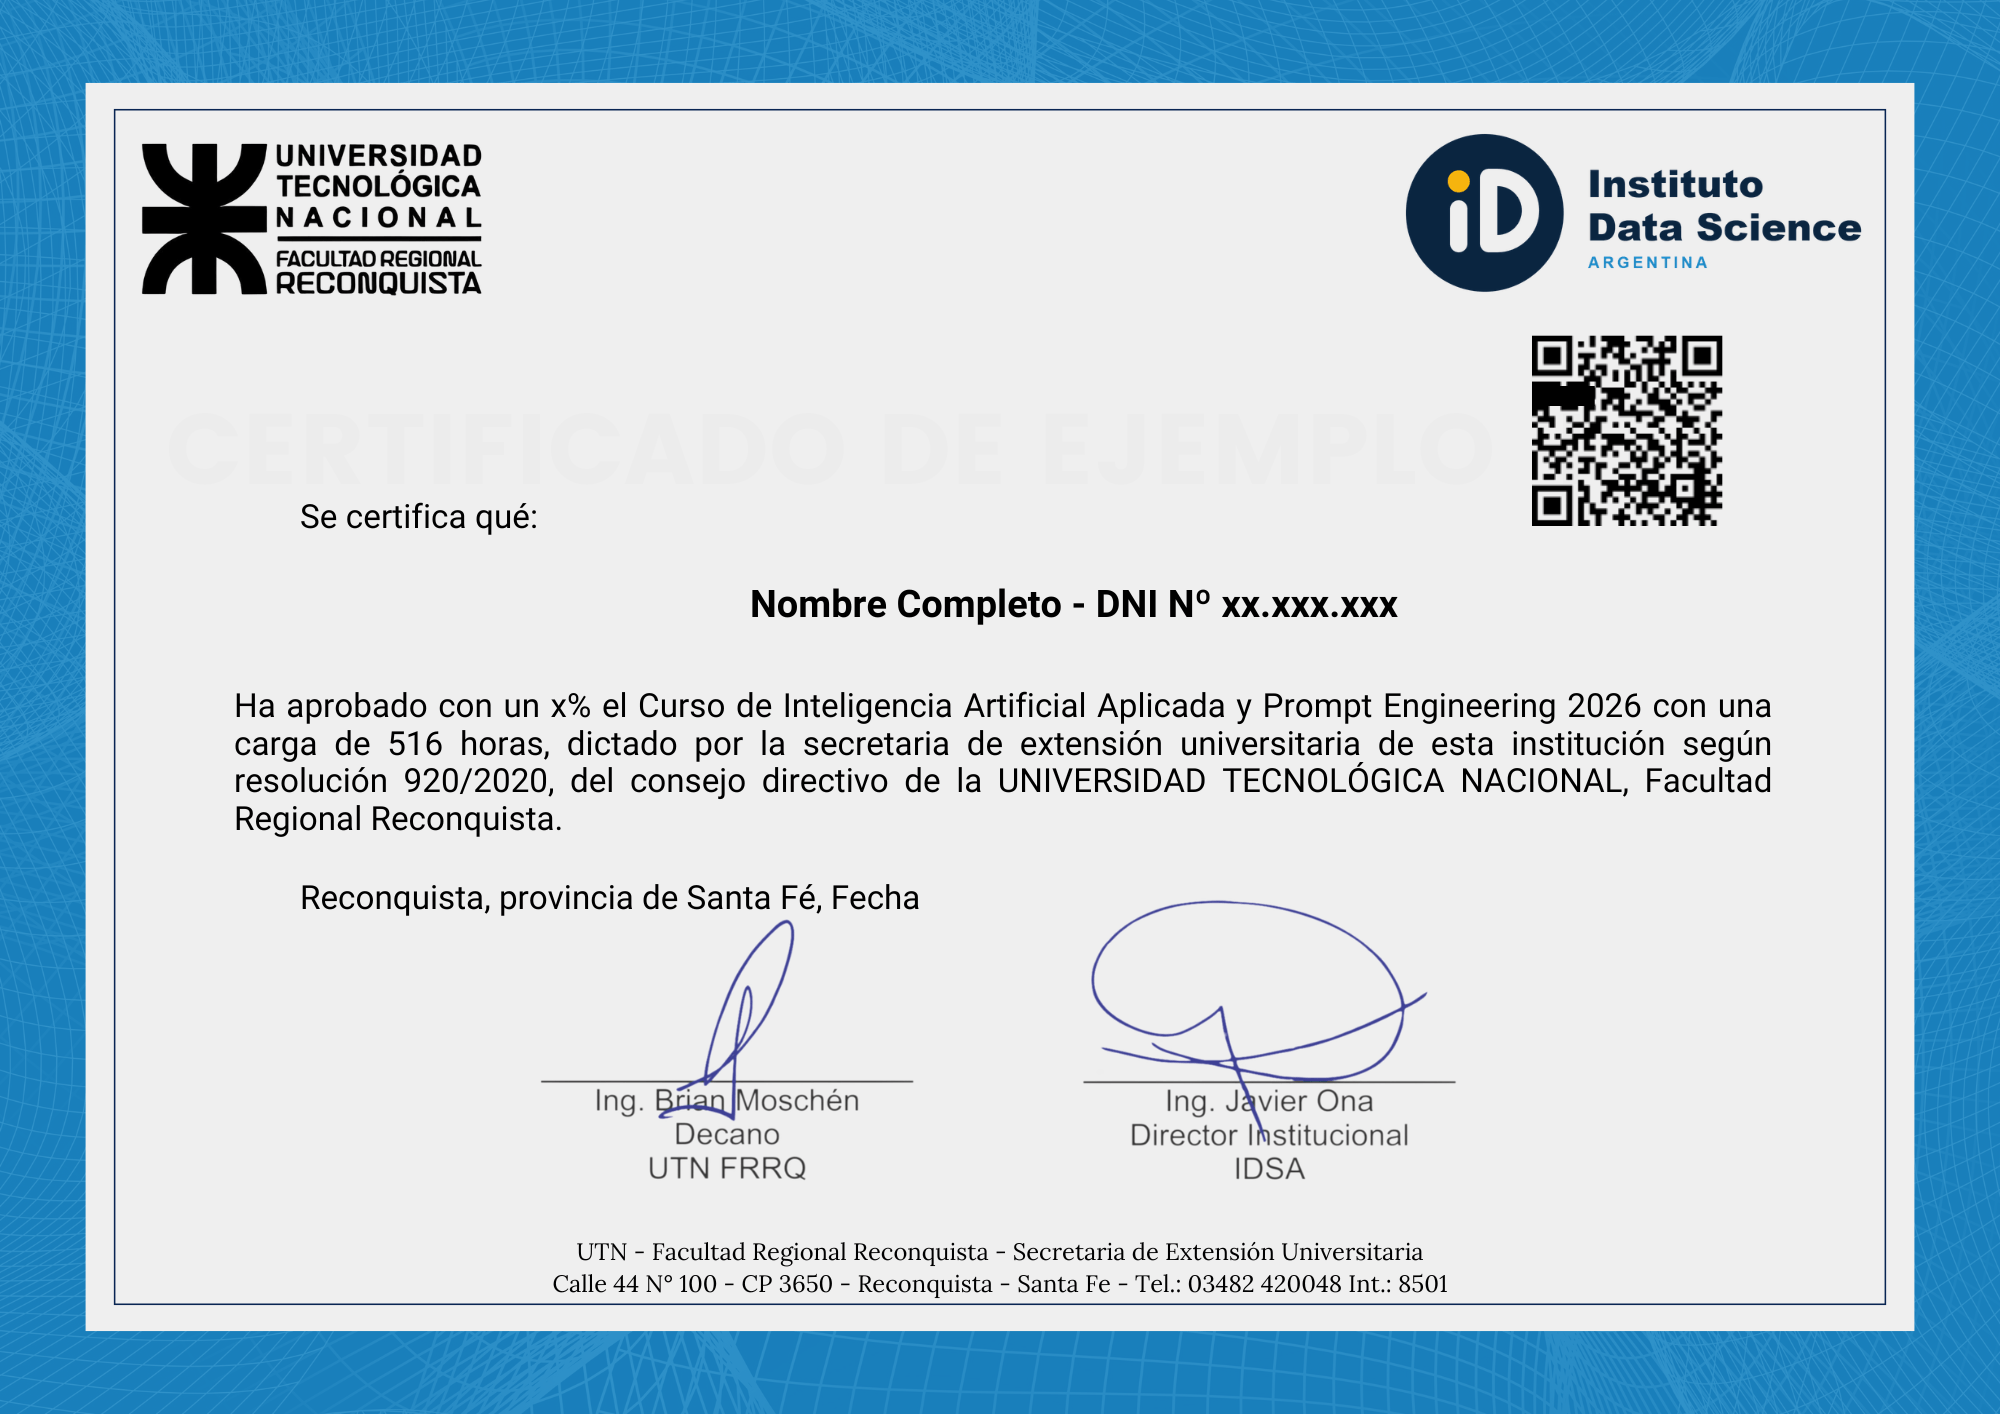
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
Del texto crudo a la decisión de negocio
10 unidades, 30 horas, con proyecto integrador end-to-end. Transformers, NER y scoring crediticio.