MLOps y Regresión
Entrená modelos de regresión, desplegalos como servicio con FastAPI y Docker, monitoreá drift en producción y automatizá el reentrenamiento. Del notebook al pipeline productivo.
def lifecycle(data):
model = train(data, params)
mlflow.log(model, metrics)
serve = deploy(model, api=“fast”)
while monitor(serve):
serve = retrain(data)
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables con corrección automática. Los entregables se acumulan en un proyecto integrador final.
Entrenar y evaluar modelos de regresión con scikit-learn
Refactorizar notebooks en módulos de producción
Gestionar experimentos con MLflow
Versionar datos y modelos con DVC
Desplegar modelos como servicios con FastAPI
Empaquetar aplicaciones con Docker y alternativas sin Docker
Monitorear el rendimiento de un modelo en producción
Detectar data drift y concept drift
Diseñar pipelines de reentrenamiento automático
Calcular el ROI de un modelo bien desplegado
Documentar y comunicar el ciclo de vida de un modelo
10 unidades · 3 horas cada una
Del notebook experimental al pipeline productivo con monitoreo y reentrenamiento automático.
- Repasar los conceptos fundamentales de regresión
- Entrenar modelos con scikit-learn
- Evaluar modelos con métricas apropiadas
- Comprender las diferencias entre notebook y script de producción
- Refactorizar código de análisis en funciones reutilizables
- Estructurar un proyecto de machine learning profesional
- Instalar y configurar MLflow
- Registrar experimentos, parámetros y métricas
- Versionar modelos con MLflow Model Registry
- Comprender por qué versionar datos y modelos
- Usar DVC para versionado de datos
- Integrar versionado con el pipeline de ML
- Construir una API para servir un modelo
- Usar FastAPI para exponer predicciones
- Documentar la API con OpenAPI
- Comprender qué es un contenedor
- Escribir un Dockerfile para una aplicación de ML
- Construir y ejecutar imágenes Docker
- Comprender por qué monitorear un modelo en producción
- Implementar métricas de monitoreo
- Detectar problemas de rendimiento
- Comprender los conceptos de drift
- Detectar data drift y concept drift
- Diseñar estrategias de mitigación
- Diseñar un pipeline de reentrenamiento automático
- Automatizar el ciclo de vida del modelo
- Orquestar tareas con Airflow o Prefect
- Aplicar todo lo aprendido en un proyecto completo
- Desplegar un modelo end-to-end
- Documentar y comunicar el ciclo de vida
Diseñado para profesionales que practican
100% autogestionado y asincrónico. Cada unidad incluye lecciones, notebooks en Colab y un entregable verificado automáticamente. Los entregables se acumulan en un proyecto integrador final.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso responde tus dudas de forma clara y directa, sin abrumar con citas extensas.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Lecciones en texto
Contenido teórico estructurado y referenciado. Sin videos interminables: lee, consulta, avanza.
- Escritas y referenciadas
- Búsqueda instantánea
- Ritmo personal
Notebooks en Google Colab
Notebooks ejecutables con código real. No pseudocódigo: cada concepto se implementa y se ejecuta.
- Ejecución sin configuración
- Código paso a paso
- GPU disponible en Colab
Proyecto integrador acumulativo
Cada entregable se acumula en un proyecto final: un modelo de regresión desplegado, monitoreado y automatizado end-to-end.
- Corrección automática por unidad
- Proyecto creciente y acumulativo
- Feedback inmediato
Del notebook al pipeline productivo
Cada unidad avanza un paso en el ciclo de vida del modelo, desde el entrenamiento hasta el reentrenamiento automático.
Entrenar
Modelos de regresión con métricas objetivas.
Empaquetar
Refactorizar, contenerizar, versionar.
Desplegar
Servir como API y monitorear en producción.
Automatizar
Detectar drift y reentrenar sin intervención.
Herramientas que usarás
Sin fricción de configuración local. Notebooks en Colab, despliegue en la nube.
 Python
 scikit-learn
 MLflow
 DVC
 FastAPI
 Docker
 Airflow
 Prefect
 Google Colab
Doble aval universitario, verificación digital
Al completar el curso recibís un certificado digital con doble aval: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
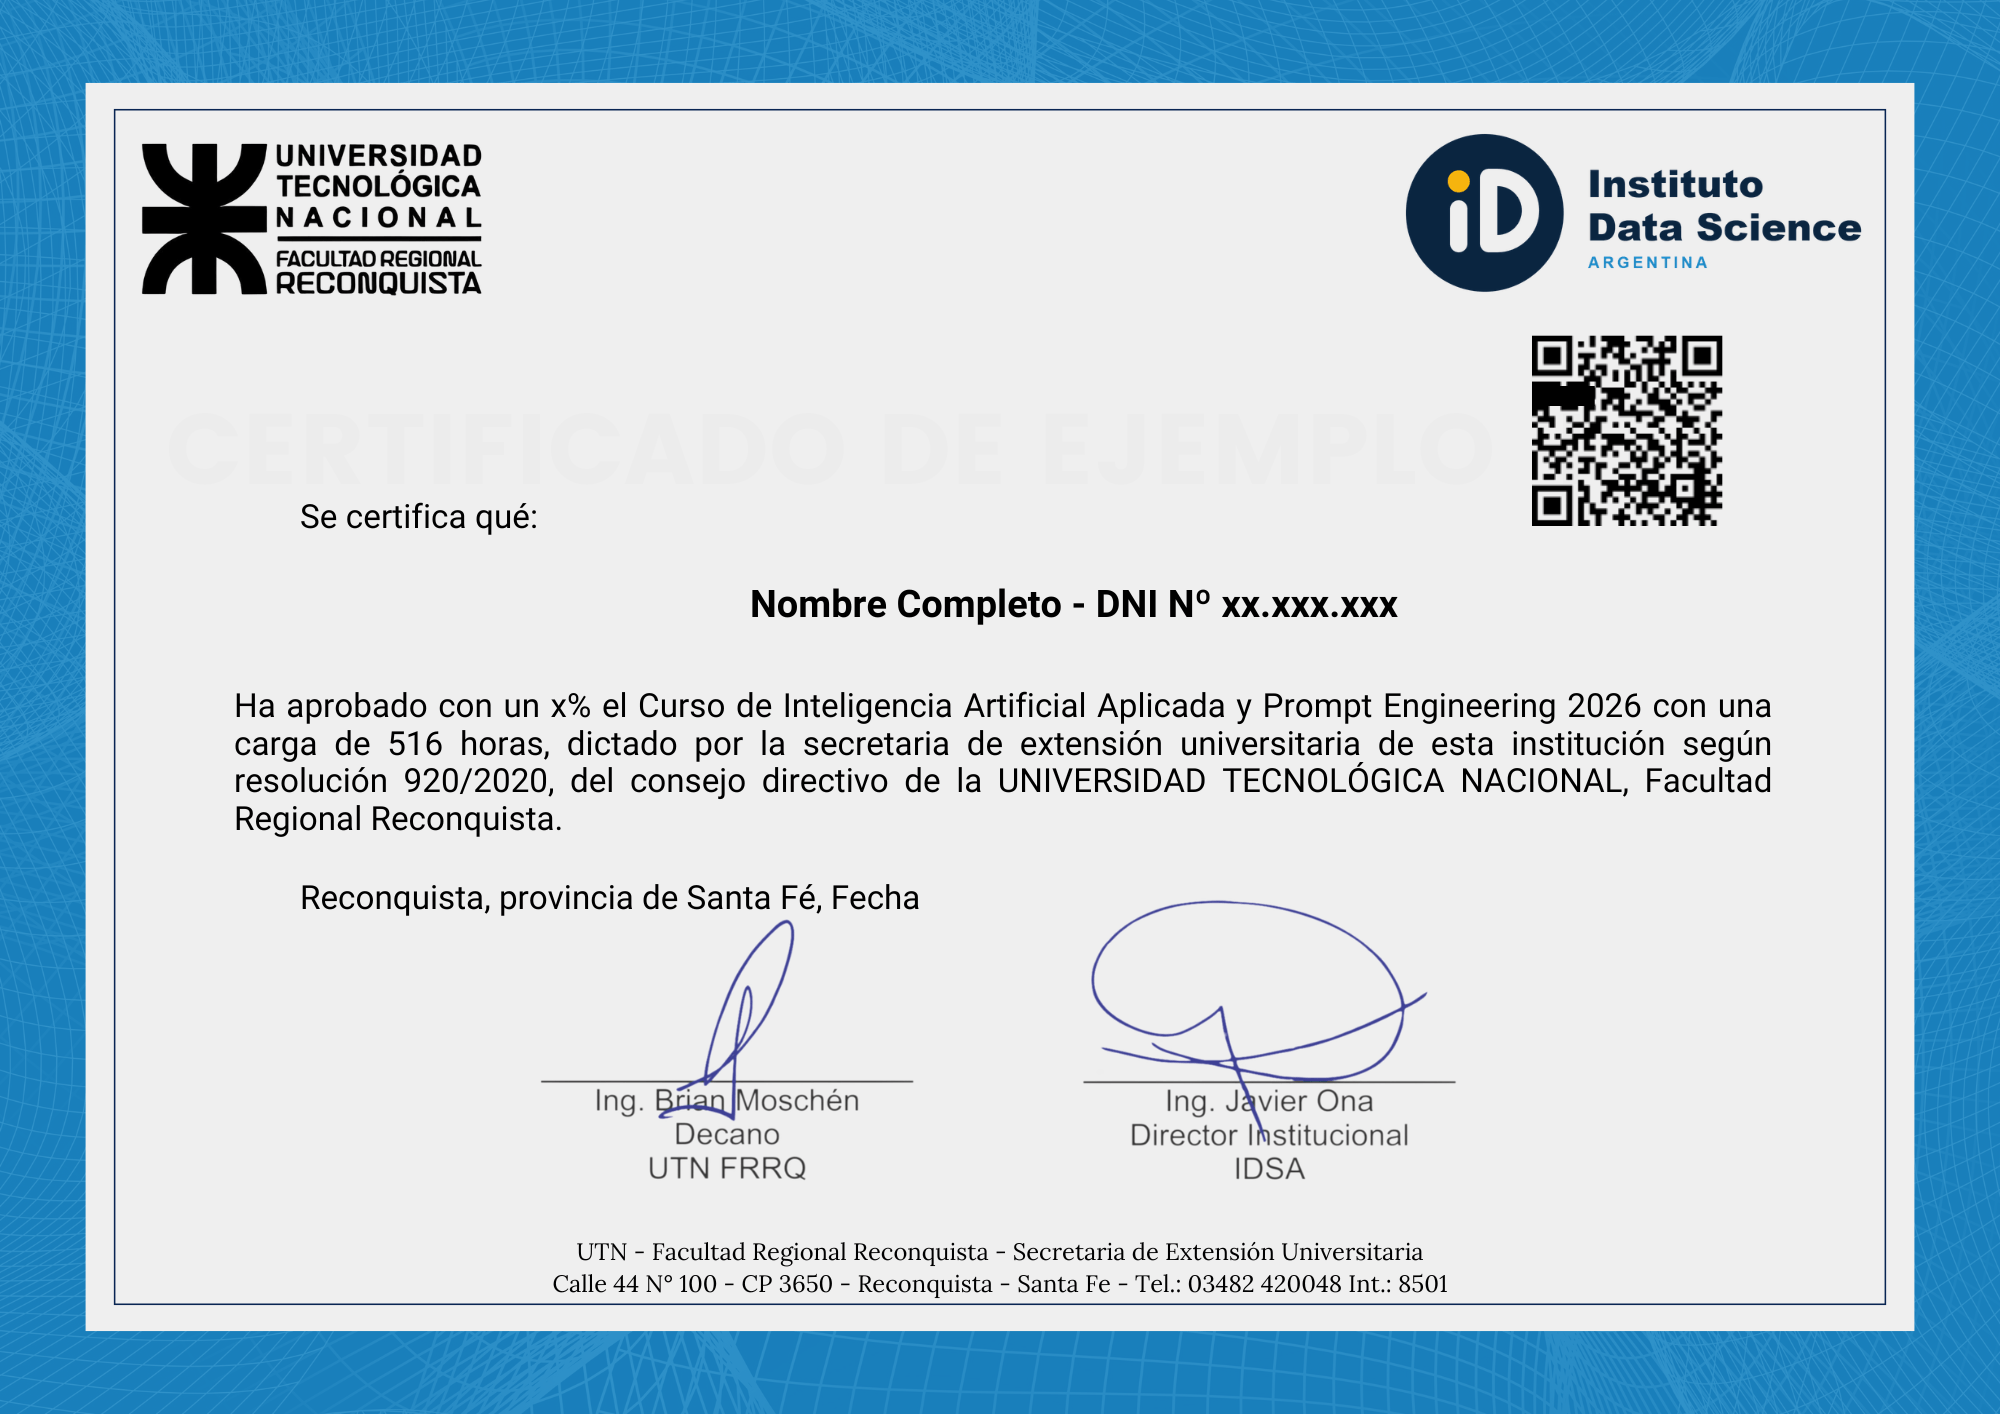
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
Del notebook al pipeline productivo
10 unidades, 30 horas, con proyecto integrador acumulativo. Sin videos pasivos, sin autoevaluación subjetiva.