MLOps Avanzado: K8s y Feature Store
Dominá Kubernetes, KServe, Feast, MLflow, Kubeflow Pipelines y Evidently. Construí una plataforma MLOps completa con criterio de reproducibilidad, observabilidad y costo, y defendela ante un comité técnico.
def platform():
feats = feast.apply()
model = mlflow.register()
serve = kserve.deploy(model)
while evidently.drift(serve):
kubeflow.retrain()
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables con corrección automática. Sin ambigüedades, sin autoevaluación subjetiva.
Diseñar, desplegar y operar una plataforma MLOps completa sobre Kubernetes
Diagnosticar los cuellos de botella de un proceso de ML ad-hoc
Construir imágenes Docker productivas y optimizadas para modelos de ML
Desplegar aplicaciones en Kubernetes (pods, deployments, services, ingress)
Servir modelos con KServe siguiendo el estándar de K8s
Diseñar y operar un Feature Store con Feast
Versionar modelos y experimentos con MLflow
Orquestar pipelines de ML con Kubeflow Pipelines
Monitorear drift y performance con Evidently + Prometheus
Automatizar el reentrenamiento con triggers basados en métricas
Implementar CI/CD para modelos de ML en K8s
Documentar decisiones arquitectónicas con ADRs y diagramas C4
10 unidades · 3 horas cada una
Progresión estructurada: del diagnóstico del caos actual al proyecto integrador con una plataforma MLOps completa sobre Kubernetes.
- Identificar los síntomas de un proceso de ML no sistemático
- Mapear el flujo actual del modelo: entrenamiento, features, serving, monitoreo
- Priorizar los problemas según impacto en el negocio
- Construir imágenes Docker optimizadas para modelos de ML
- Comprender multi-stage builds y reducción de tamaño
- Preparar imágenes para servir en Kubernetes
- Comprender los objetos fundamentales de Kubernetes
- Desplegar una aplicación simple en K8s
- Diagnosticar problemas comunes en pods
- Comprender el estándar de serving en K8s
- Desplegar un modelo con KServe / KFServing
- Configurar autoscaling basado en requests
- Comprender el problema de la consistencia train/serve
- Diseñar un Feature Store con Feast
- Implementar features compartidas entre equipos
- Comprender el ciclo de vida de un modelo con MLflow
- Versionar experimentos, modelos y artefactos
- Servir modelos con MLflow Model Registry
- Comprender la orquestación de pipelines de ML
- Construir un pipeline con Kubeflow Pipelines
- Comprender cuándo usar Kubeflow vs alternativas
- Comprender los tipos de drift y su impacto en modelos
- Implementar monitoreo con Evidently
- Exportar métricas a Prometheus y Grafana
- Automatizar el reentrenamiento basado en triggers
- Implementar CI/CD para modelos de ML
- Diseñar el ciclo de vida completo del modelo
- Diseñar una plataforma MLOps completa para un caso real
- Documentar decisiones con ADRs y diagramas C4
- Presentar y defender la plataforma ante un comité técnico
Diseñado para profesionales que operan ML en producción
100% autogestionado y asincrónico. Tutor virtual 24/7, notebooks en JupyterLite o Google Colab/entorno local, y repos de GitHub de referencia.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso responde tus dudas de forma clara y directa, sin abrumar con citas extensas.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Repos de GitHub de referencia
Material de lectura y código funcional en repositorios versionados. No pseudocódigo: cada componente de la plataforma se implementa en un entorno real.
- Repos versionados
- Manifiestos K8s listos
- Commits didácticos
Notebooks en JupyterLite, Colab o local
Notebooks ejecutables con código real. Podés correrlos en JupyterLite (navegador), Google Colab o tu entorno local.
- JupyterLite o Colab
- Entorno local opcional
- Código paso a paso
Entregables verificados
Cada unidad tiene entregables obligatorios con verificación automática: manifiestos K8s válidos, feature views funcionales, pipelines ejecutados y monitoreo activo.
- Corrección automática
- Criterios objetivos
- Feedback inmediato
Del caos a la plataforma en cada unidad
Ciclo estructurado que se repite en las 10 unidades para consolidar competencias verificables.
Diagnosticar
Entender el problema real y priorizar por impacto.
Empaquetar
Docker + Kubernetes + serving.
Operar
Feature Store, tracking, pipelines y monitoreo.
Defender
ADRs, C4 y comité técnico.
Herramientas que usarás
Todo se ejecuta en JupyterLite, Google Colab o tu entorno local. Repos de GitHub con manifiestos y código de referencia.
 Python
 Docker
 Kubernetes KServe
 Feast
 MLflow
 Kubeflow Evidently
 Prometheus
 Grafana
 GitHub Actions
 JupyterLite
 Google Colab
 GitHub
Doble aval universitario, verificación digital
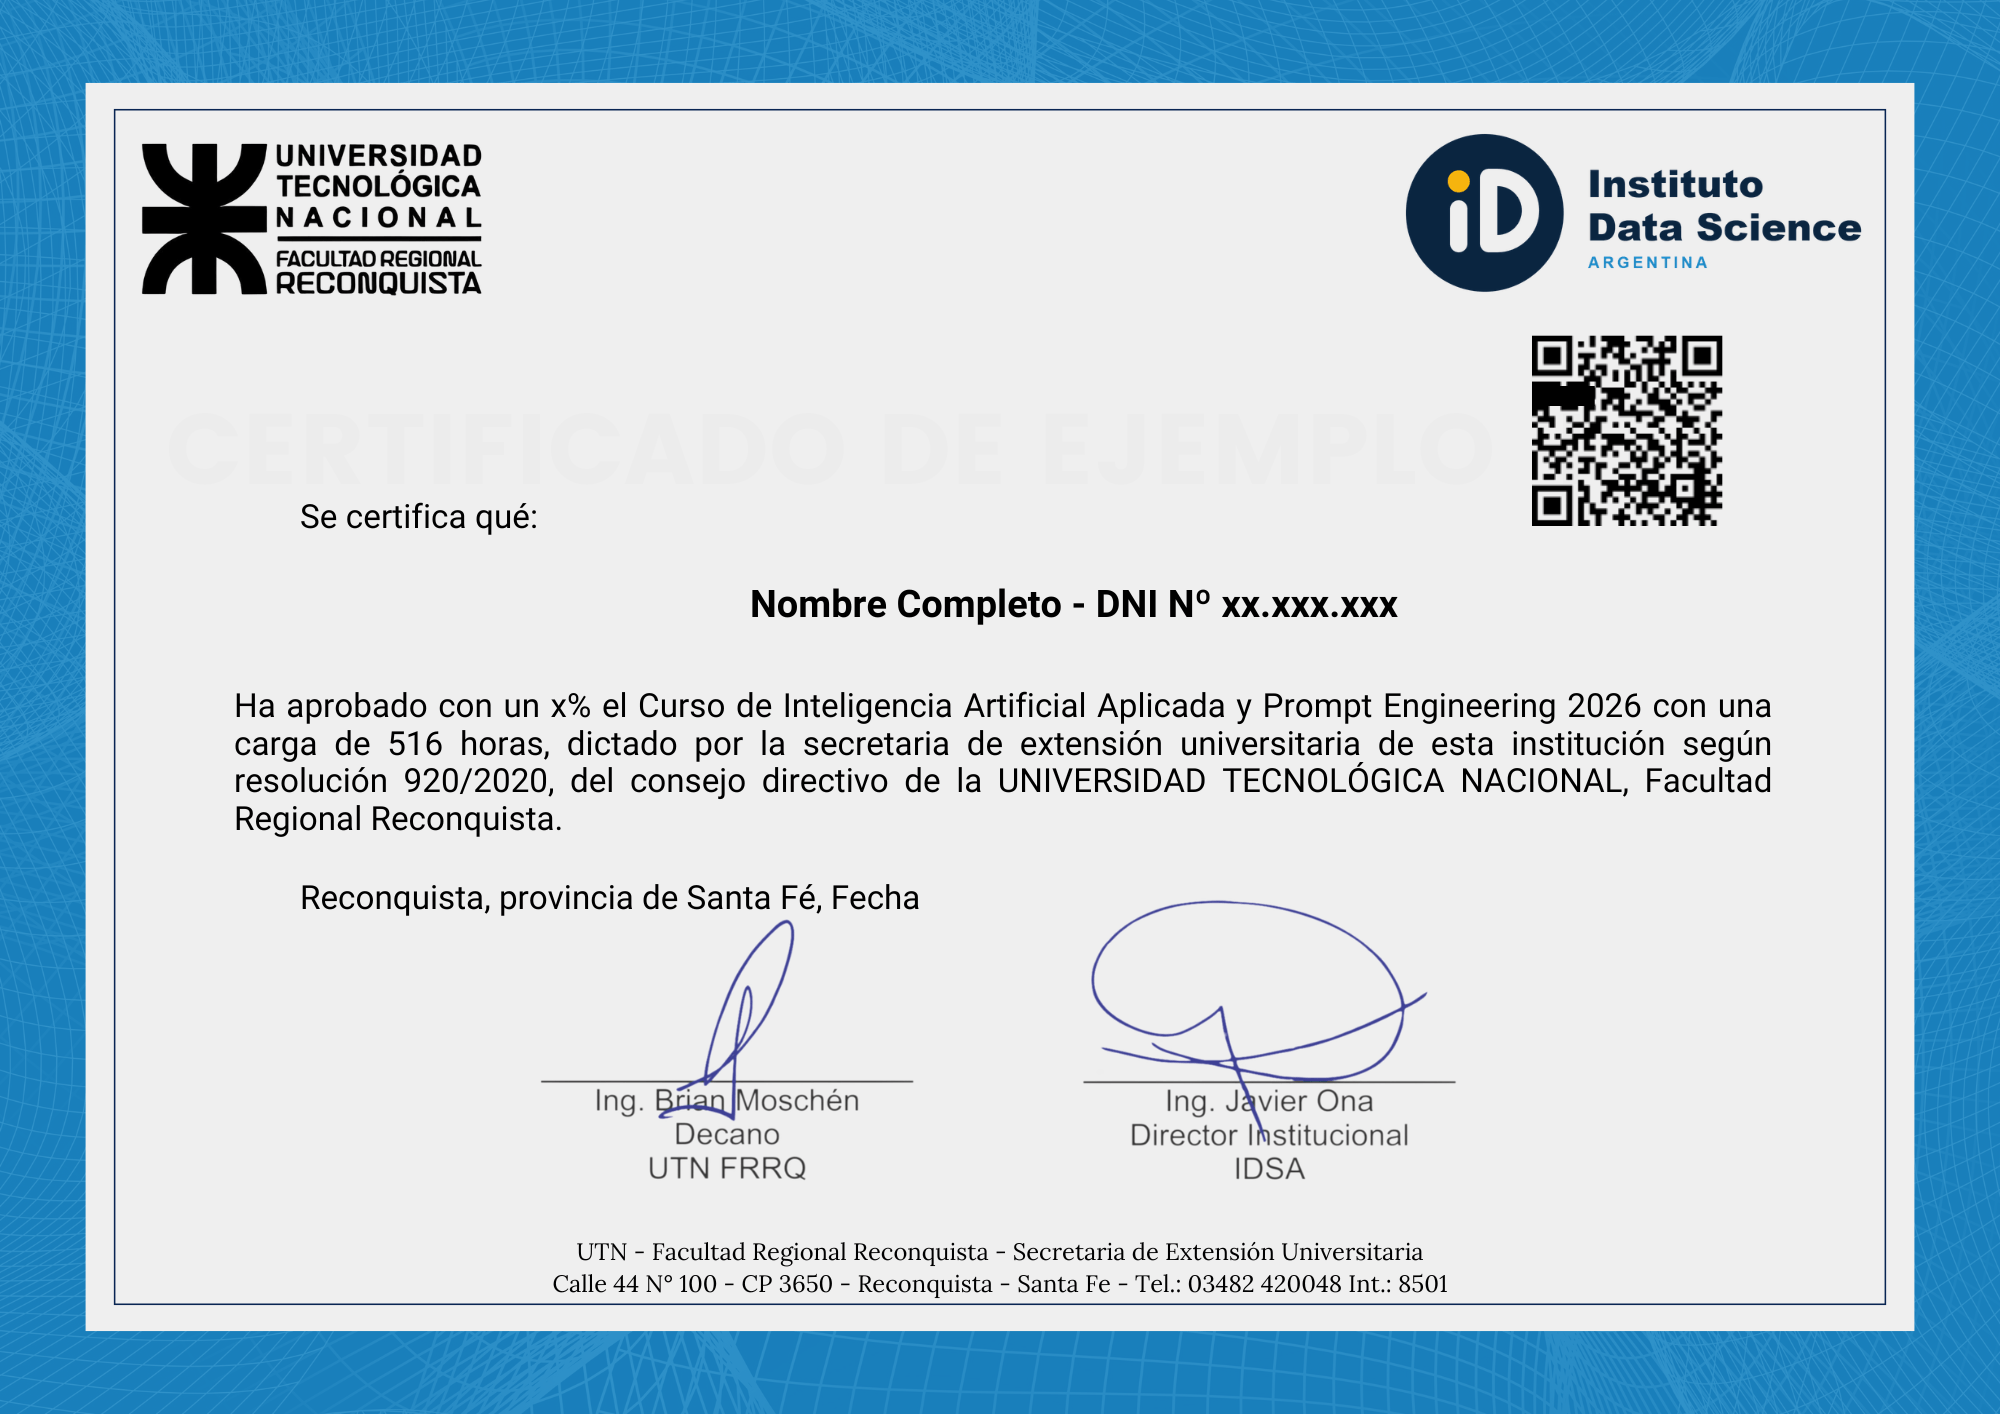
Al completar el curso recibís un certificado digital con doble aval: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
Del caos a la plataforma MLOps completa
10 unidades, 30 horas, con proyecto integrador end-to-end. Kubernetes, KServe, Feast, MLflow y Kubeflow.