Machine Learning Supervisado y No Supervisado
Entrená, validá y explicá modelos de Machine Learning con scikit-learn, XGBoost y LightGBM. Un caso de riesgo de mora de una fintech, de principio a fin: baseline, ensambles, validación, umbral de decisión, SHAP y segmentación de clientes.
pipe = Pipeline([
(“prep”, prep),
(“gbm”, LGBMClassifier())
])
cross_val_score(pipe, X, y,
cv=StratifiedKFold(5), scoring=“roc_auc”)
Del dato al modelo que podés defender
Cada objetivo es verificable mediante entregables y defensa conversacional. Vas a poder entrenar, validar y explicar modelos de ML, y justificar cada decisión.
Plantear un problema de ML con baseline, partición correcta de datos y métrica alineada al negocio
Entrenar y comparar regresión logística, árboles, random forest y gradient boosting
Validar con validación cruzada, detectar leakage y manejar clases desbalanceadas
Elegir el umbral de decisión según el costo de cada error y explicar un modelo con SHAP
Segmentar clientes con clustering y reducir dimensionalidad con PCA
Entregar un score de crédito para Fintora con informe ejecutivo y defensa conversacional
6 unidades · 30 horas
Cada unidad incluye lecciones, un quiz de corrección automática y un entregable en un notebook de Google Colab.
- Supervisado y no supervisado: cómo plantear el problema
- Train, validación y test; pipelines de scikit-learn
- Regresión lineal, baseline, sobreajuste y leakage
- Regresión logística y árboles: cómo deciden y cómo se leen
- Matriz de confusión, precision, recall, ROC y PR
- Elegir el umbral según el costo de cada error
- Bagging y boosting: por qué combinar modelos funciona
- Random forest, XGBoost y LightGBM
- Ajuste de hiperparámetros y control del sobreajuste
- Validación cruzada estratificada y temporal; detección de leakage
- Clases desbalanceadas: pesos, submuestreo y SMOTE; calibración
- Importancia por permutación y SHAP para explicar el modelo
- k-means, clustering jerárquico y DBSCAN
- PCA para reducir dimensionalidad y visualizar
- Evaluar clusters: silhouette y criterio de negocio
- Score de crédito para Fintora: del baseline al modelo final
- Segmentación de clientes e informe ejecutivo
- Defensa conversacional de tus decisiones
- 10 preguntas al azar de un banco de 20 · 40 minutos · 2 intentos
- Se aprueba con 6 sobre 10
- Aprobarlo habilita el certificado
Diseñado para profesionales que practican
100% autogestionado y asincrónico. Cada unidad incluye lecciones, un quiz y un entregable en Google Colab con controles automáticos y defensa conversacional.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso resuelve tus dudas y evalúa tu comprensión mediante defensa conversacional.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Lecciones en texto
Contenido estructurado en el campus, con la matemática justa y ejemplos paso a paso. Leé, consultá y avanzá a tu ritmo.
- Ejemplos paso a paso
- Búsqueda instantánea
- Ritmo personal
Notebooks en Google Colab
Notebooks ejecutables con código real y GPU disponible. No pseudocódigo: cada técnica se entrena y se evalúa.
- Sin instalación
- GPU disponible
- Código paso a paso
Entregables con defensa conversacional
Cada unidad tiene un entregable con controles automáticos y una defensa conversacional. Recibís feedback sobre tu trabajo y tus decisiones.
- Controles automáticos
- Defensa conversacional
- Criterios claros
Del problema de negocio al modelo, con validación
Cada técnica se explica, se entrena sobre datos de Fintora y se valida antes de pasar a la siguiente.
Plantear
Problema, baseline y métrica.
Entrenar
Modelos con scikit-learn y boosting.
Validar
Validación cruzada y control de leakage.
Explicar
Umbral, SHAP y segmentos de clientes.
Herramientas que usarás
Sin fricción de configuración. Todo se ejecuta en Google Colab.
 Python
 pandas
 scikit-learn
 XGBoost
 Matplotlib
 Google Colab
Doble aval universitario, verificación digital
Al aprobar el curso descargás tu certificado desde el campus y podés tramitar la homologación del certificado oficial: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
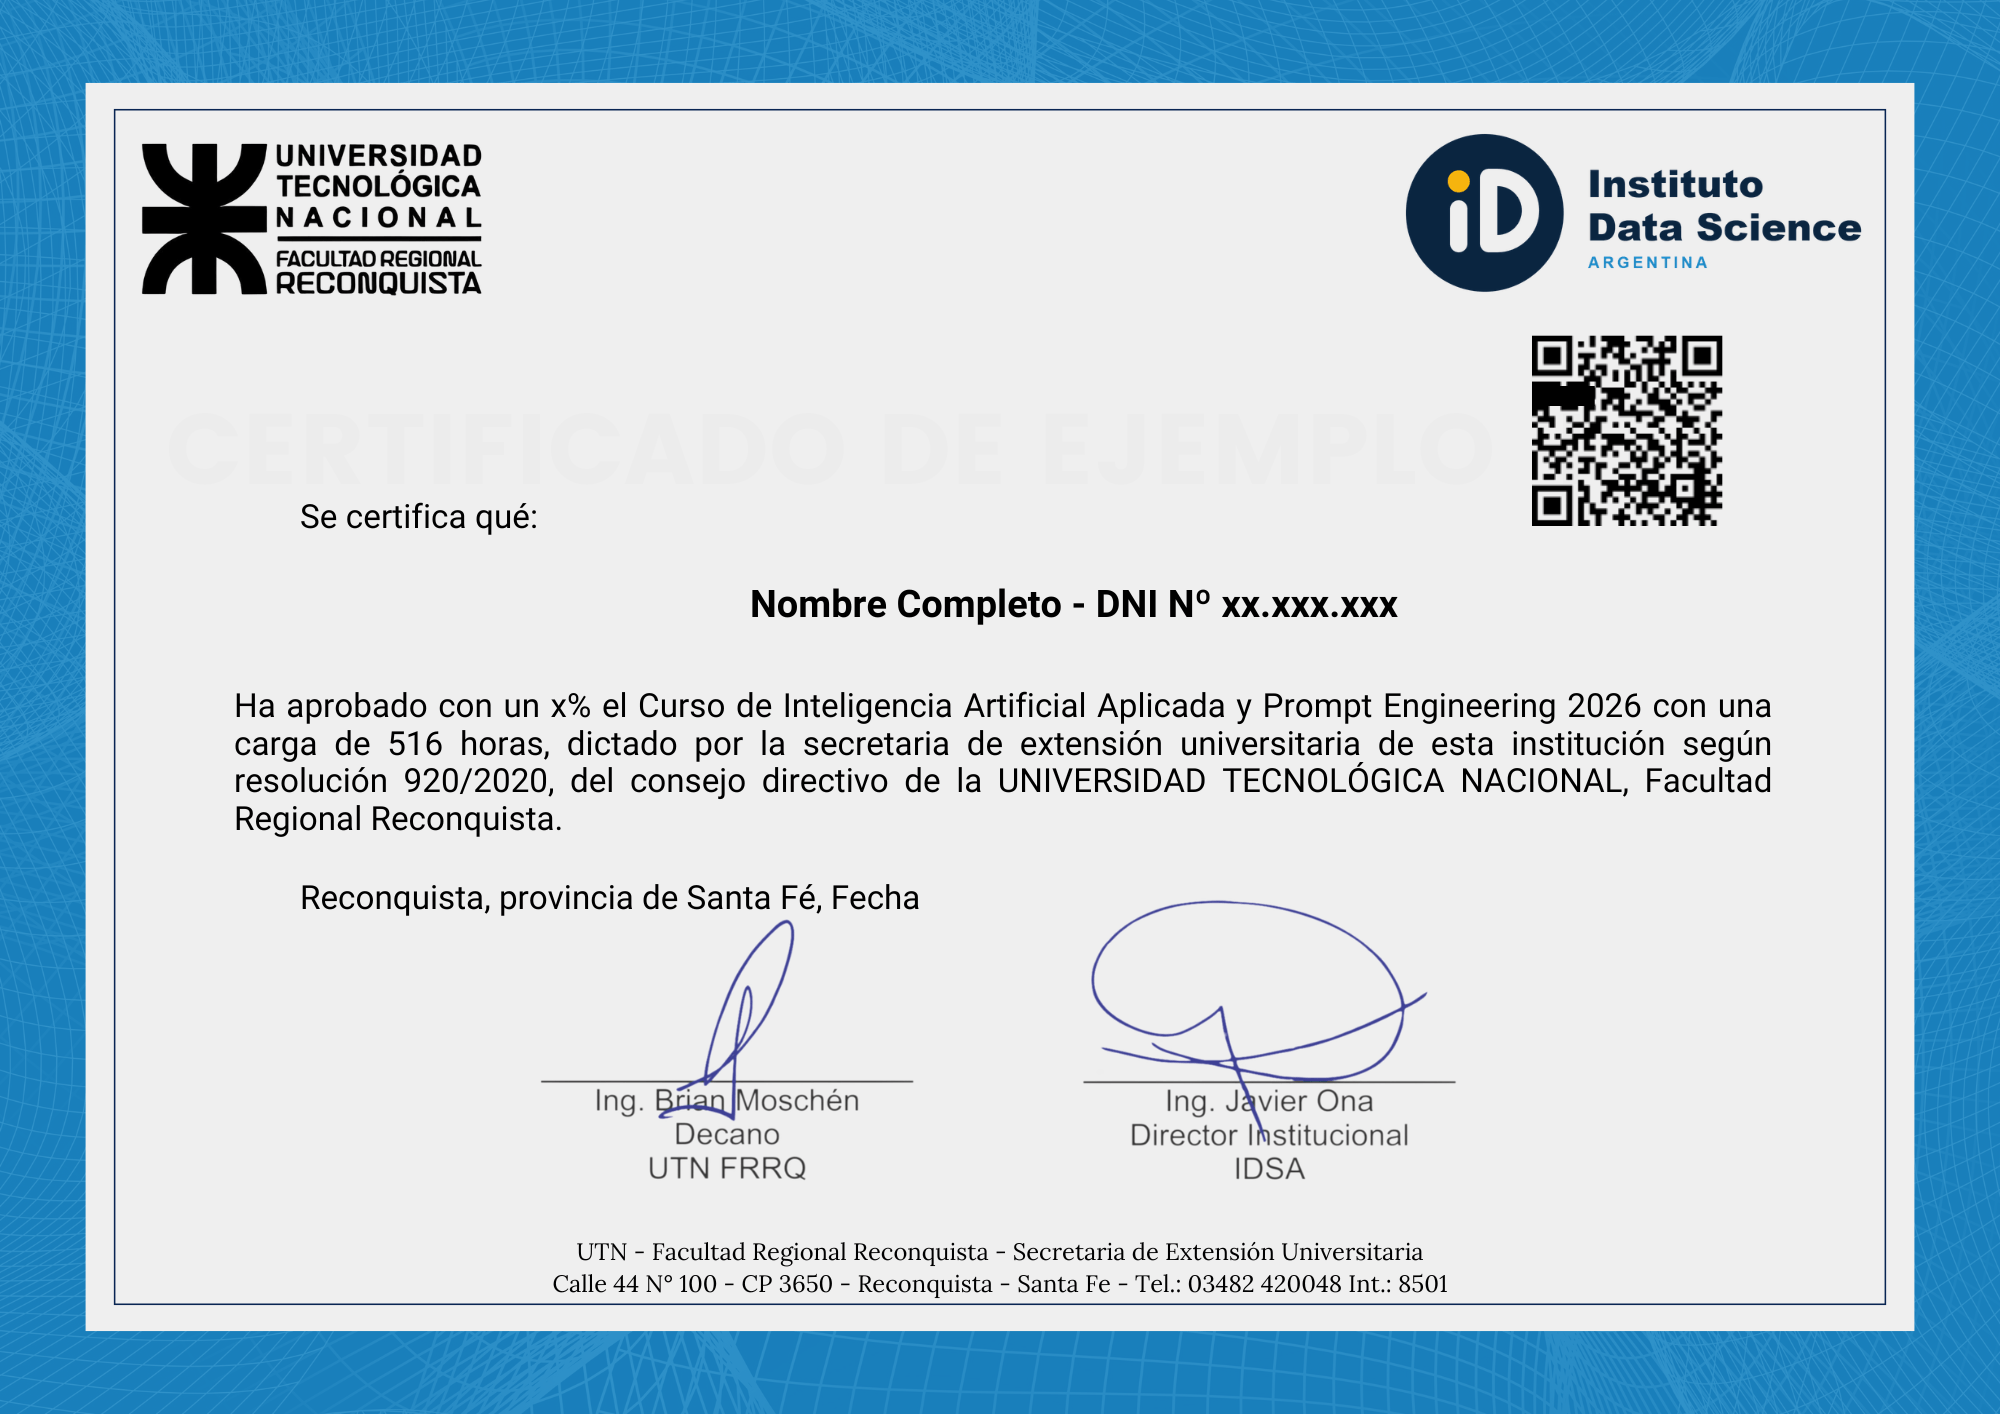
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Homologación a pedido: enviás el certificado del campus y tu DNI a info@institutodatascience.org y recibís el certificado oficial por correo
- Emisión por curso: no esperás al final del trayecto
Se habilita al aprobar el Examen Final del curso (nota mínima 6 sobre 10).
Resolvemos tus dudas
Del dato al modelo que se puede explicar
6 unidades, 30 horas, verificable y aplicable. Con un caso de riesgo de mora y certificación IDSA + UTN.