Computer Vision Aplicada
Diseñá, entrená y desplegá modelos de visión para documentos escaneados y detección de fraude. De OpenCV y transfer learning a YOLO, DETR, OCR, SAM, U-Net y detección de anomalías visuales.
def process(image):
bbox = detect(image)
text = ocr(bbox)
score = fraud_model(bbox, text)
return decision(score)
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables con corrección automática. Sin ambigüedades, sin autoevaluación subjetiva.
Diseñar, entrenar y desplegar modelos de visión para documentos escaneados y detección de fraude
Comprender el pipeline de visión end-to-end: imagen a decisión
Procesar y aumentar imágenes con OpenCV y torchvision
Entrenar clasificadores de imágenes con transfer learning
Detectar objetos con modelos de la familia YOLO / DETR
Extraer texto de imágenes con OCR (Tesseract, EasyOCR, TrOCR)
Segmentar regiones de interés con SAM y U-Net
Detectar anomalías visuales y montajes
Trabajar con datasets pequeños y desbalanceados
Servir modelos de visión optimizados para latencia
Integrar visión con texto y datos tabulares
Documentar decisiones y comunicar resultados al área de negocio
10 unidades · 3 horas cada una
Progresión estructurada: del pipeline end-to-end al proyecto integrador con foco en documentos escaneados y detección de fraude.
- Comprender el pipeline completo: imagen → decisión
- Identificar los componentes de un sistema de visión
- Definir métricas de éxito técnicas y de negocio
- Manipular imágenes con OpenCV
- Aplicar transformaciones con torchvision
- Diseñar estrategias de data augmentation efectivas
- Seleccionar backbones preentrenados adecuados
- Implementar fine-tuning eficiente
- Evaluar con métricas apropiadas para clases desbalanceadas
- Entrenar detectores con YOLO
- Comprender la arquitectura de DETR
- Evaluar con mAP e IoU
- Extraer texto con Tesseract
- Usar EasyOCR para escenarios multilingües
- Aplicar TrOCR para texto manuscrito
- Segmentar regiones de interés con SAM
- Entrenar U-Net para segmentación semántica
- Aplicar segmentación a documentos
- Detectar anomalías visuales con autoencoders
- Identificar montajes y manipulaciones
- Aplicar a detección de fraude documental
- Aplicar few-shot learning y data augmentation agresivo
- Implementar focal loss y oversampling
- Evaluar con curvas precision-recall
- Optimizar modelos para latencia (cuantización, ONNX, TensorRT)
- Integrar visión con texto y datos tabulares
- Servir modelos en producción con SLAs claros
- Diseñar y desplegar un sistema completo de visión
- Documentar decisiones con ADRs y diagramas C4
- Comunicar resultados al área de negocio
Diseñado para profesionales que construyen visión en producción
100% autogestionado y asincrónico. Notebooks en JupyterLite o Google Colab, modelos y datasets desde Hugging Face Hub.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso responde tus dudas de forma clara y directa, sin abrumar con citas extensas.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Contenido en Moodle
Lecciones estructuradas y referenciadas en texto. Sin videos interminables: leé, consultá y avanzá a tu ritmo.
- Plataforma Moodle
- Búsqueda instantánea
- Ritmo personal
Notebooks en JupyterLite y Google Colab
Notebooks ejecutables con código real. Cada técnica de visión se implementa y se ejecuta sobre modelos y datasets reales.
- JupyterLite o Colab
- Código paso a paso
- Modelos desde Hugging Face Hub
Proyecto integrador acumulativo
Cada entregable se acumula en un sistema de visión completo para documentos escaneados y detección de fraude.
- Corrección automática por unidad
- Proyecto creciente y acumulativo
- Presentación al área de negocio
De la imagen cruda a la decisión de negocio
Un ciclo claro que parte del procesamiento de imágenes y llega al despliegue de un sistema end-to-end con integración multimodal.
Procesar
OpenCV, torchvision y aumentación.
Detectar
Clasificación, detección, OCR y segmentación.
Analizar
Anomalías, montajes y datasets pequeños.
Servir
Latencia, multimodalidad y negocio.
Herramientas que usarás
Todo se ejecuta en JupyterLite o Google Colab con modelos y datasets descargables desde Hugging Face Hub.
 Python
 OpenCV
 PyTorch torchvision
 YOLO
 DETR Tesseract EasyOCR TrOCR
 SAM U-Net Hugging Face Hub
 JupyterLite
 Google Colab
 Moodle
Doble aval universitario, verificación digital
Al completar el curso recibís un certificado digital con doble aval: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
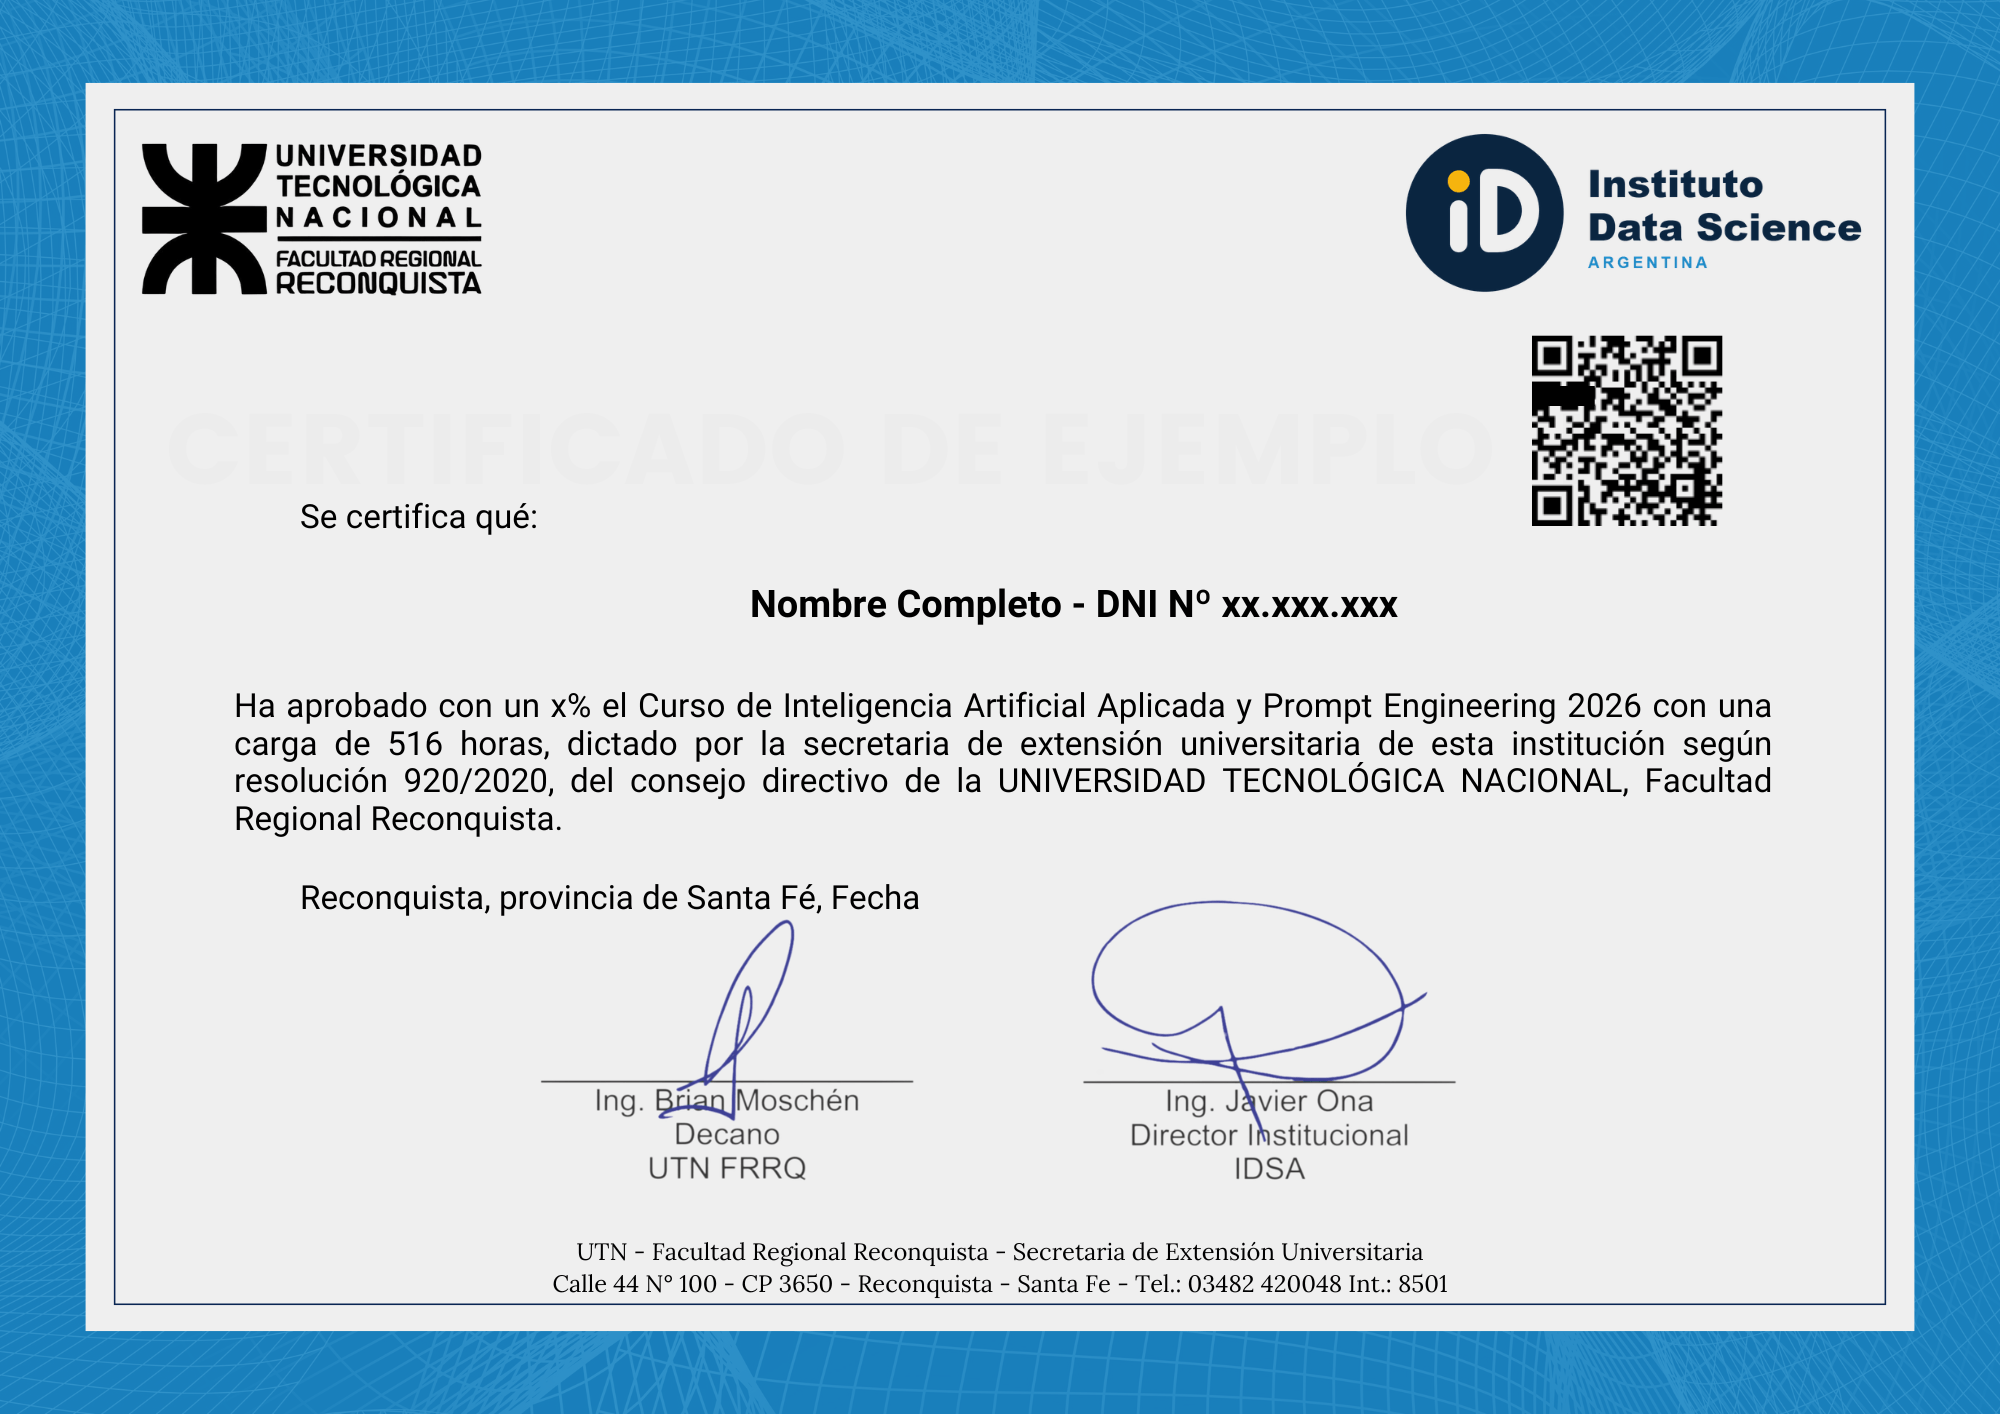
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
De la imagen cruda a la decisión de negocio
10 unidades, 30 horas, con proyecto integrador end-to-end. Documentos escaneados y detección de fraude.