Arquitectura de Datos y Data Mesh
Diseñá la arquitectura de datos de una organización multi-país. Del diagnóstico de la fragmentación al roadmap de implementación en 18 meses, con decisiones justificadas con ADRs y diagramas C4.
def pipeline(source):
bronze = ingest(source)
silver = clean(bronze)
gold = model(silver)
return publish(gold)
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables con corrección automática. Sin ambigüedades, sin autoevaluación subjetiva.
Diagnosticar la fragmentación de datos en una organización multi-sistema
Diseñar modelos de datos modernos (dimensional, Data Vault, OBT) según caso
Comprender los principios del lakehouse y las tecnologías de tabla abierta
Diseñar pipelines de ingesta batch, CDC y streaming a escala
Implementar la arquitectura medallion (bronze, silver, gold) con dbt y Spark
Comprender los principios y trade-offs de Data Mesh, Data Fabric y monolito
Diseñar dominios, productos de datos y contratos entre equipos
Implementar gobernanza de datos federada con catálogo y linaje
Diseñar y ejecutar migraciones desde warehouses legacy sin downtime
Documentar decisiones arquitectónicas con ADRs y diagramas C4
Diseñar un roadmap de implementación realista con hitos medibles
10 unidades · 3 horas cada una
Progresión estructurada: del diagnóstico de la fragmentación actual al roadmap de implementación en 18 meses.
- Comprender los síntomas de una arquitectura de datos fragmentada
- Mapear fuentes, volúmenes y flujos actuales
- Identificar los costos ocultos de la fragmentación
- Comparar enfoques de modelado: dimensional, Data Vault, OBT
- Elegir el modelo adecuado según caso de uso
- Diseñar dimensiones conformadas en un contexto multi-país
- Comprender los principios del lakehouse
- Comparar Iceberg, Delta Lake y Hudi
- Diseñar la arquitectura de almacenamiento multi-region
- Diseñar pipelines de ingesta batch productivos
- Implementar CDC desde bases relacionales
- Comprender cuándo usar batch, micro-batch y streaming
- Implementar la arquitectura medallion (bronze, silver, gold)
- Transformar datos con dbt y Spark
- Diseñar modelos de negocio en la capa gold
- Comprender los principios de Data Mesh y Data Fabric
- Comparar los tres enfoques según contexto organizacional
- Tomar una decisión arquitectónica fundamentada
- Diseñar dominios de datos para una organización federada
- Definir productos de datos con SLAs y consumidores
- Implementar contratos de datos entre equipos
- Diseñar gobernanza de datos federada en 3 países
- Implementar catálogo, linaje y observabilidad de datos
- Cumplir con regulaciones heterogéneas de LATAM
- Diseñar una migración sin downtime del warehouse legacy
- Implementar patrones dual-write, cutover progresivo y rollback
- Validar integridad de datos post-migración
- Integrar todos los conocimientos en una arquitectura completa
- Diseñar un roadmap de implementación realista en 18 meses
- Documentar decisiones arquitectónicas con ADRs y diagramas C4
Diseñado para profesionales que practican
100% autogestionado y asincrónico. Avanzá a tu ritmo, con verificación automática de cada entregable.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso responde tus dudas de forma clara y directa, sin abrumar con citas extensas.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Material de lectura estructurado
Contenido teórico referenciado y repositorios versionados. Sin videos interminables: leé, consultá, avanzá.
- Escrito y referenciado
- Repos versionados
- Ritmo personal
Notebooks en JupyterLite y Google Colab
Notebooks ejecutables con código real. Cada concepto de arquitectura se implementa y se ejecuta sobre datos reales.
- Ejecución sin configuración
- JupyterLite o Colab
- Spark, dbt y lakehouse en acción
Quizzes y entregables verificables
Cada unidad tiene quizzes y entregables obligatorios con verificación automática. Sabés exactamente si cumple o no cumple.
- Corrección automática
- Criterios objetivos
- Feedback inmediato
De la teoría al roadmap en cada unidad
Ciclo estructurado que se repite en las 10 unidades para consolidar competencias verificables.
Diagnóstico
Entender la organización y sus restricciones reales. Sin recetas genéricas.
Diseño
Modelar, comparar alternativas y decidir con criterio arquitectónico.
Implementación
Pipelines, lakehouse y medallion en notebooks ejecutables.
Documentación
ADRs, diagramas C4 y roadmap con hitos medibles.
Herramientas que usarás
Sin fricción de configuración. Todo se ejecuta en JupyterLite o Google Colab.
 Python
 Apache Spark
 dbt
 Apache Iceberg
 Delta Lake
Apache Hudi
 Debezium
 GitHub
 Google Colab
 JupyterLite
Doble aval universitario, verificación digital
Al completar el curso recibís un certificado digital con doble aval: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
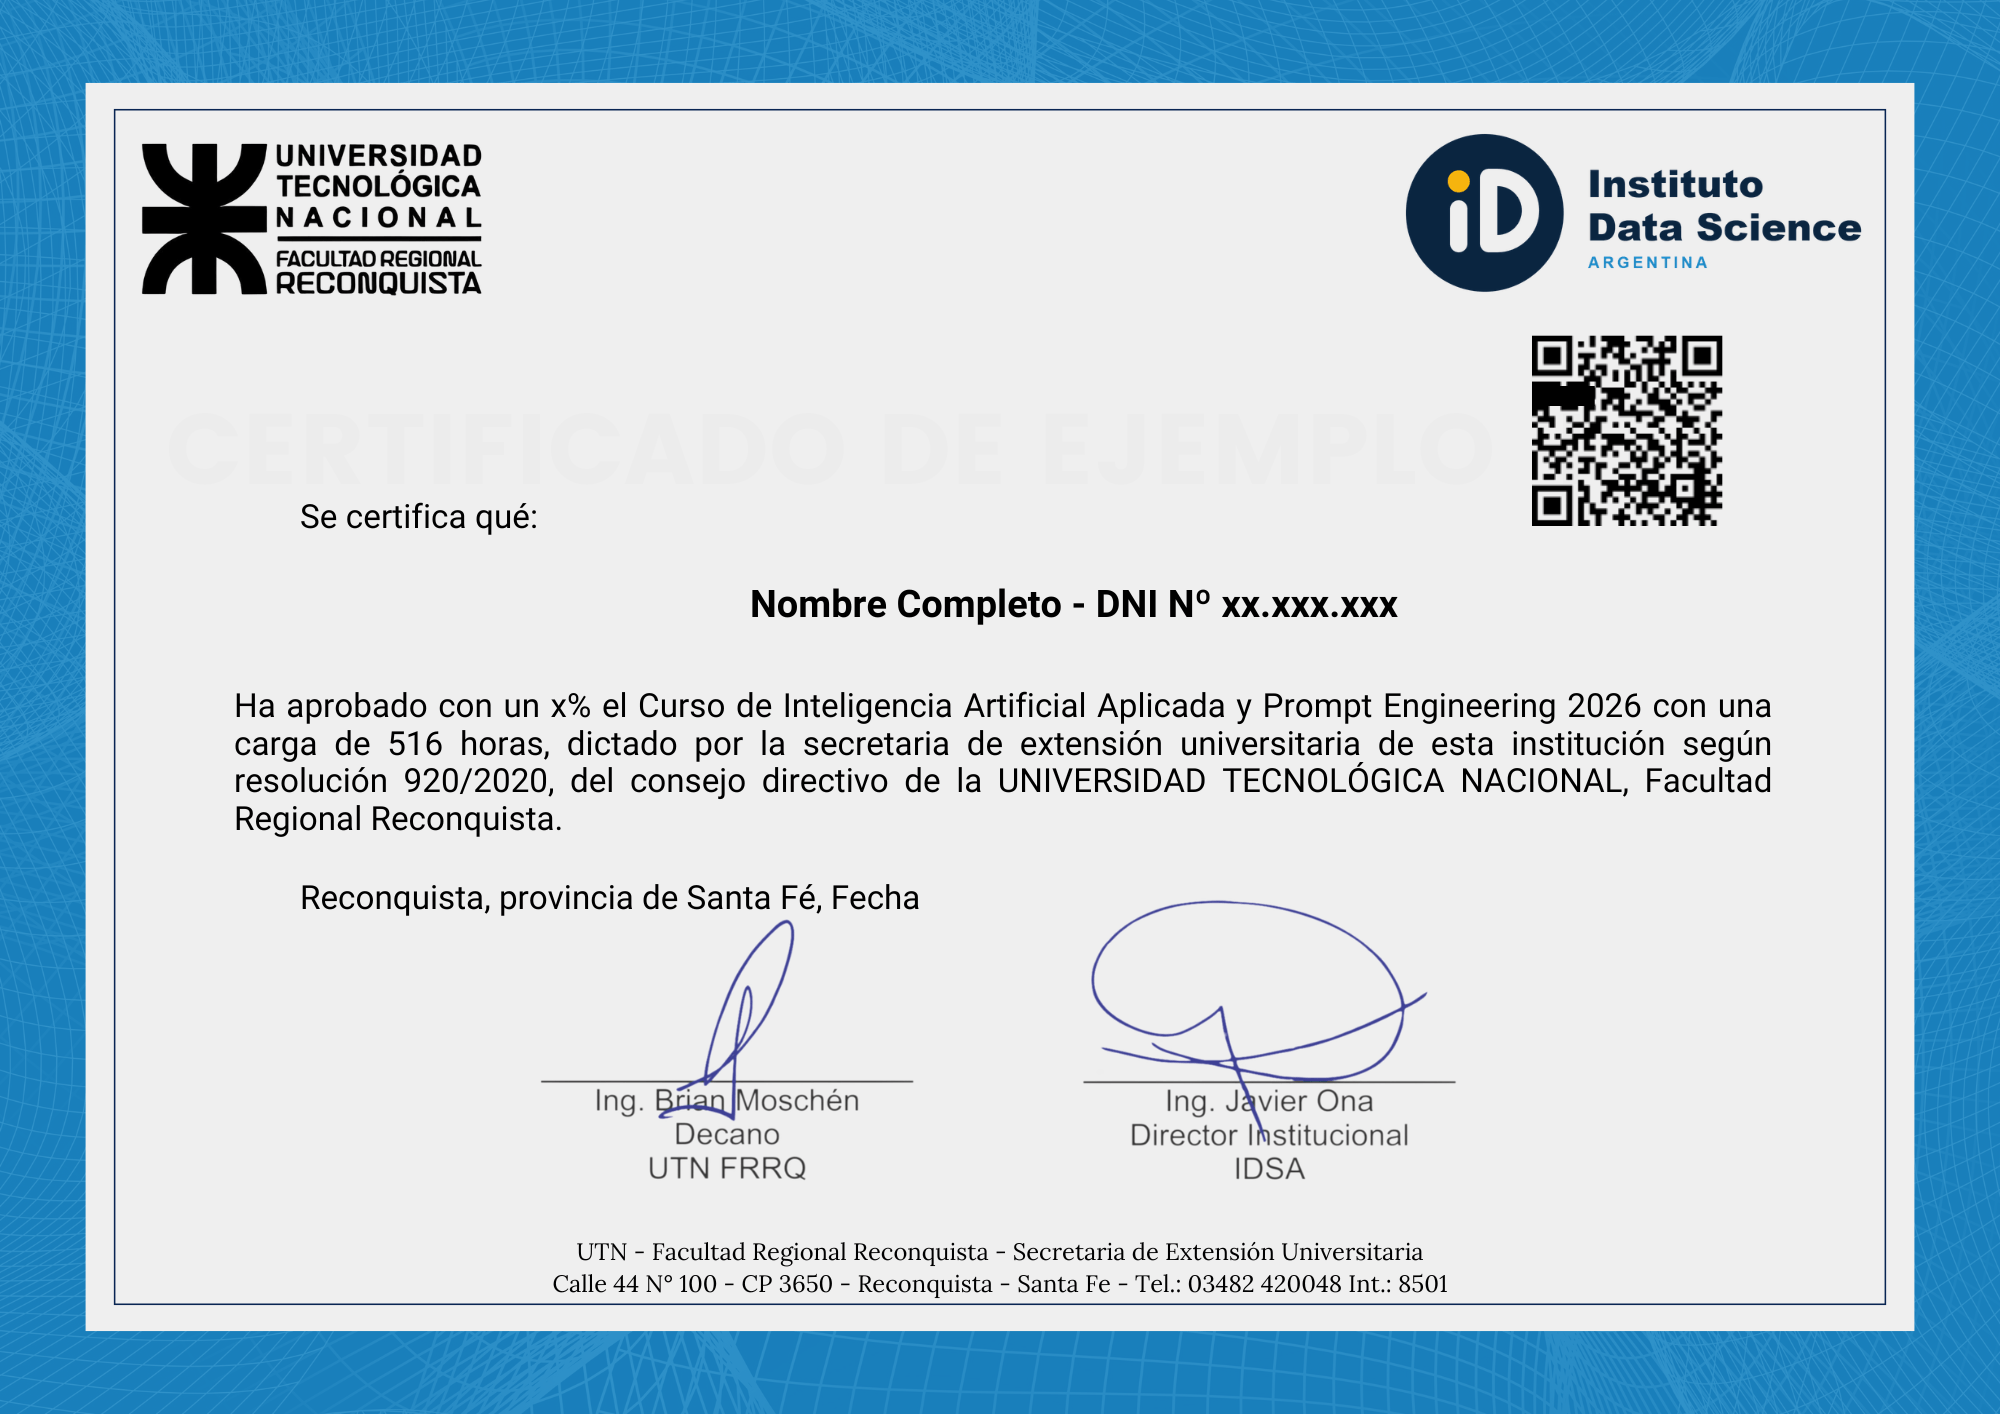
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
Empezá a diseñar la arquitectura de datos de tu organización
10 unidades, 30 horas, verificable y aplicable. Sin videos pasivos, sin autoevaluación subjetiva.