SQL para Data Science
Aprendé SQL desde cero con foco en análisis de datos. Del SELECT básico a window functions, funnels, cohortes y optimización de consultas. Sin experiencia previa en bases de datos.
with cohorts as (
select user_id,
min(date_trunc(‘month’, created_at)) as cohort
from users
group by 1
)
select cohort, count(*) as size
from cohorts group by 1
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables con corrección automática. Sin ambigüedades, sin autoevaluación subjetiva.
Comprender el modelo relacional y sus componentes
Escribir consultas SELECT con filtros, orden y límites
Agregar y agrupar datos con GROUP BY y funciones de agregación
Cruzar tablas con los distintos tipos de JOIN
Usar subconsultas y CTEs para estructurar consultas complejas
Aplicar window functions para análisis avanzado
Construir análisis de funnels y cohortes
Detectar y resolver problemas de calidad de datos
Optimizar consultas con índices y EXPLAIN
Documentar consultas y decisiones técnicas
Presentar hallazgos a stakeholders no técnicos
10 unidades · 2 horas cada una
Progresión estructurada: del modelo relacional al proyecto integrador con análisis completo y presentación a stakeholders.
- Comprender el modelo relacional y sus componentes
- Identificar claves primarias, foráneas y tipos de datos
- Escribir las primeras consultas SELECT
- Filtrar datos con WHERE y operadores lógicos
- Ordenar resultados con ORDER BY
- Manejar NULLs correctamente
- Usar funciones de agregación (COUNT, SUM, AVG, MIN, MAX)
- Agrupar datos con GROUP BY
- Filtrar grupos con HAVING
- Comprender los distintos tipos de JOIN
- Cruzar tablas relacionales correctamente
- Identificar y evitar errores comunes (productos cartesianos)
- Escribir subconsultas en distintos lugares del SELECT
- Usar CTEs para estructurar consultas complejas
- Elegir entre subconsultas y CTEs según el caso
- Comprender el concepto de window functions
- Aplicar ROW_NUMBER, RANK, LAG, LEAD
- Usar funciones de agregación como window functions
- Construir análisis de funnels de conversión
- Analizar cohortes de clientes
- Medir retención y churn
- Detectar problemas de calidad de datos con SQL
- Debuggear consultas que no devuelven lo esperado
- Construir validaciones reutilizables
- Comprender cómo el motor ejecuta consultas
- Aplicar índices y reescribir queries lentas
- Documentar y versionar consultas profesionalmente
- Integrar todos los conocimientos en un análisis completo
- Documentar decisiones de query y hallazgos
- Presentar resultados a stakeholders no técnicos
Diseñado para quienes empiezan con SQL
100% autogestionado y asincrónico. Notebooks en JupyterLite (SQLite) o Google Colab (DuckDB/PostgreSQL) y tutor virtual 24/7.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso responde tus dudas de forma clara y directa, sin abrumar con citas extensas.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Ideal para quienes empiezan
Contenido en Moodle
Lecciones estructuradas y referenciadas en texto. Sin videos interminables: leé, consultá y avanzá a tu ritmo.
- Plataforma Moodle
- Búsqueda instantánea
- Ritmo personal
Notebooks en JupyterLite y Google Colab
Notebooks ejecutables con SQL real. Cada concepto se aplica sobre bases de datos de ejemplo con datos reales.
- JupyterLite (SQLite)
- Google Colab (DuckDB/PostgreSQL)
- Ejecución sin instalación
Entregables verificados
Cada unidad tiene entregables obligatorios con verificación automática. Sabés exactamente si la consulta cumple o no cumple.
- Corrección automática
- Criterios objetivos
- Feedback inmediato
Del SELECT al análisis completo
Un ciclo claro que parte de las consultas básicas y llega al análisis de funnels, cohortes y optimización de queries.
Consultar
SELECT, WHERE, ORDER BY y JOINs.
Agregar
GROUP BY, HAVING y CTEs.
Analizar
Window functions, funnels y cohortes.
Optimizar
Índices, EXPLAIN y buenas prácticas.
Herramientas que usarás
Sin instalación local. Todo se ejecuta en JupyterLite (SQLite en el navegador) o Google Colab (DuckDB/PostgreSQL en la nube).
 SQL
 SQLite
 DuckDB
PostgreSQL
 JupyterLite
 Google Colab
 Moodle
 GitHub
Doble aval universitario, verificación digital
Al completar el curso recibís un certificado digital con doble aval: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
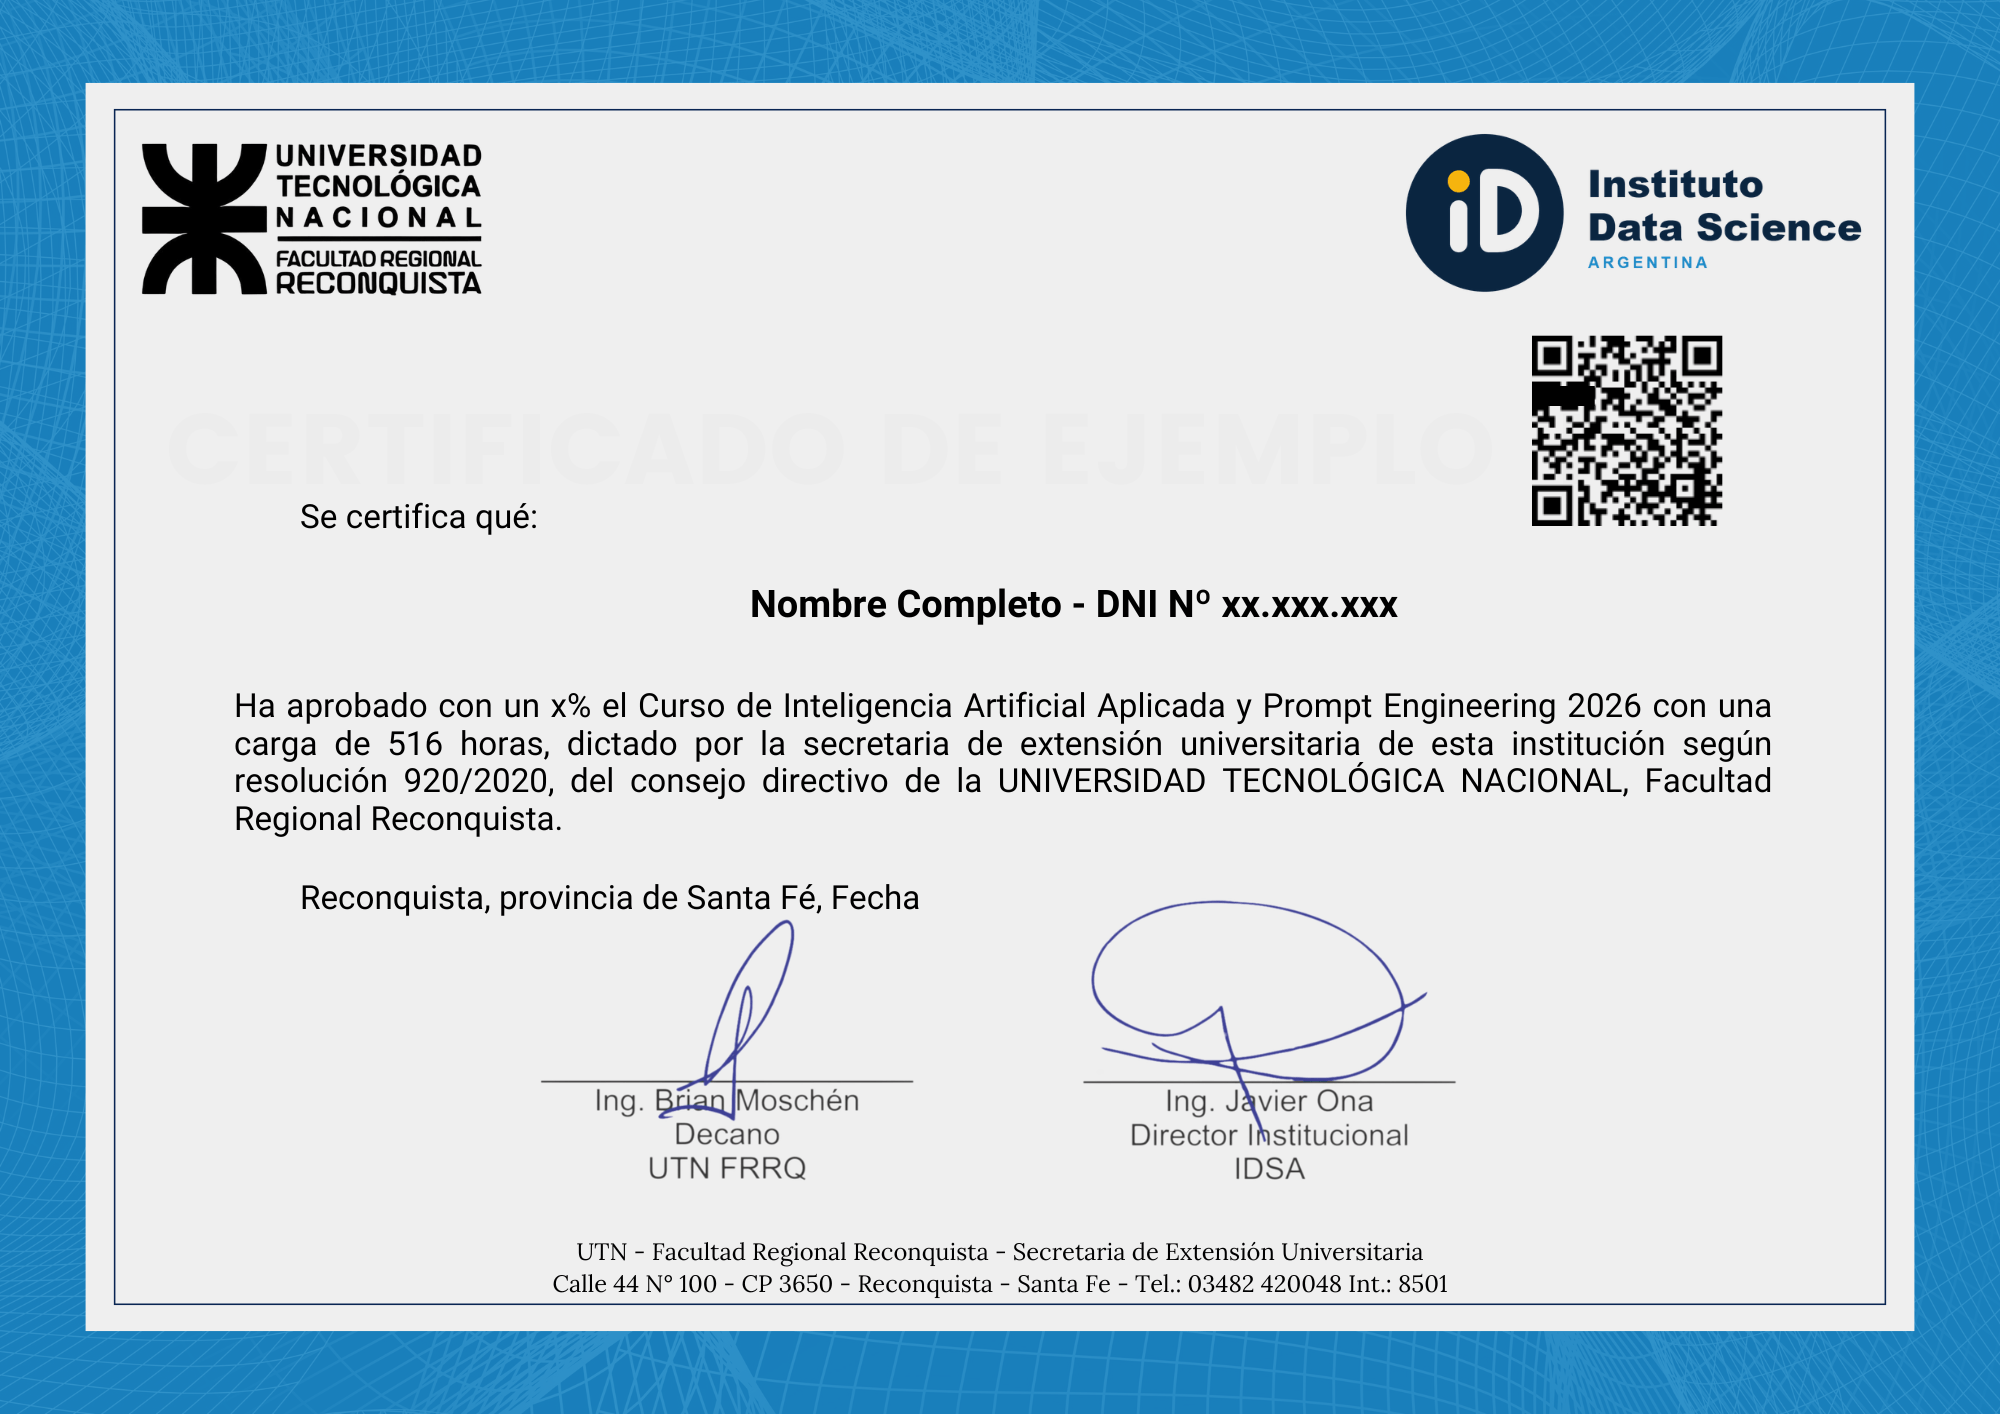
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
Del SELECT al análisis completo
10 unidades, 20 horas, con proyecto integrador end-to-end. JOINs, window functions, funnels y optimización.