Fine-tuning de LLMs y Prompt Engineering
Dominá el ciclo completo de LLMs: prompts reproducibles, RAG básico y avanzado, evaluación con LLM-as-judge, fine-tuning con LoRA/QLoRA, instruction tuning con datos sintéticos, function calling y despliegue optimizado.
def answer(query):
ctx = retriever.search(query, k=5)
prompt = template(query, ctx)
out = llm.generate(prompt)
return judge(out, ctx)
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables con corrección automática. Sin ambigüedades, sin autoevaluación subjetiva.
Diseñar prompts efectivos y sistemáticos para tareas de dominio específico
Comprender cuándo usar prompt engineering, RAG o fine-tuning según el problema
Construir un pipeline RAG con vector store, reranking y evaluación de calidad
Evaluar respuestas de LLMs con métricas y jueces automáticos
Hacer fine-tuning con LoRA/QLoRA con recursos limitados
Generar datasets sintéticos de instrucciones y aplicar instruction tuning
Usar function calling y structured output para conectar LLMs con herramientas
Optimizar costos mediante caching, cuantización y modelos locales
Desplegar un sistema LLM con monitoreo y control de latencia
Documentar decisiones y limitaciones de un sistema LLM en producción
10 unidades · 3 horas cada una
Progresión estructurada: del diagnóstico inicial al proyecto integrador con un sistema LLM completo.
- Diferenciar casos donde LLM aporta vs donde no
- Mapear el problema del analista de crédito
- Definir criterios de éxito medibles
- Diseñar prompts reproducibles y versionables
- Aplicar técnicas modernas de prompting
- Medir la calidad del prompt
- Comprender la arquitectura de RAG
- Construir un RAG mínimo con vector store
- Evaluar cuándo RAG mejora la respuesta
- Mejorar la calidad de RAG con reranking y hybrid search
- Manejar documentos heterogéneos
- Optimizar la latencia sin perder calidad
- Definir métricas de evaluación apropiadas
- Implementar LLM-as-judge
- Detectar alucinaciones sistemáticamente
- Comprender cuándo fine-tuning vale la pena
- Hacer LoRA con recursos limitados
- Comparar LoRA vs prompt vs RAG
- Generar datasets sintéticos de instrucciones
- Aplicar instruction tuning con calidad
- Comprender las limitaciones de los datos sintéticos
- Usar function calling para conectar LLM con herramientas
- Generar structured output de forma confiable
- Comprender cuándo usar agentes
- Desplegar un sistema LLM en producción
- Optimizar latencia y costos
- Monitorear la calidad en producción
- Integrar todos los conocimientos
- Documentar y presentar un sistema LLM completo
- Demostrar criterio técnico y económico
Diseñado para profesionales que construyen con LLMs
100% autogestionado y asincrónico. Notebooks en JupyterLite o Google Colab con GPU gratuita o Hugging Face Spaces.
Tutor virtual 24/7
Un asistente virtual entrenado sobre el contenido del curso responde tus dudas de forma clara y directa, sin abrumar con citas extensas.
- Respuestas claras y sintéticas
- Disponible las 24 horas
- Contexto del curso completo
Contenido en Moodle
Lecciones estructuradas y referenciadas en texto. Sin videos interminables: leé, consultá y avanzá a tu ritmo.
- Plataforma Moodle
- Búsqueda instantánea
- Ritmo personal
Notebooks en JupyterLite y Google Colab
Notebooks ejecutables con código real. Cada técnica de LLM se implementa y se ejecuta sobre modelos reales.
- JupyterLite o Colab
- GPU gratuita en Colab
- Hugging Face Spaces
Proyecto integrador acumulativo
Cada entregable se acumula en un sistema LLM completo desplegado y monitoreado.
- Corrección automática por unidad
- Proyecto creciente y acumulativo
- Evaluación técnica y económica
Del prompt al sistema en producción
Un ciclo claro que parte del prompting sistemático y llega al despliegue monitoreado con criterio técnico y económico.
Prompt
Reproducible, versionable y medible.
RAG
Vector store, reranking y evaluación.
Fine-tune
LoRA/QLoRA y datos sintéticos.
Deploy
Latencia, costos y monitoreo.
Herramientas que usarás
Todo se ejecuta en JupyterLite o Google Colab con GPU gratuita, y Hugging Face Spaces para demos.
 Python
 PyTorch
 Transformers Datasets PEFT (LoRA) Hugging Face Hub
 LangChain LlamaIndex
 FAISS
 Chroma
 OpenAI API
 Moodle
 JupyterLite
 Google Colab
Doble aval universitario, verificación digital
Al completar el curso recibís un certificado digital con doble aval: Instituto Data Science Argentina y UTN Facultad Regional Reconquista.
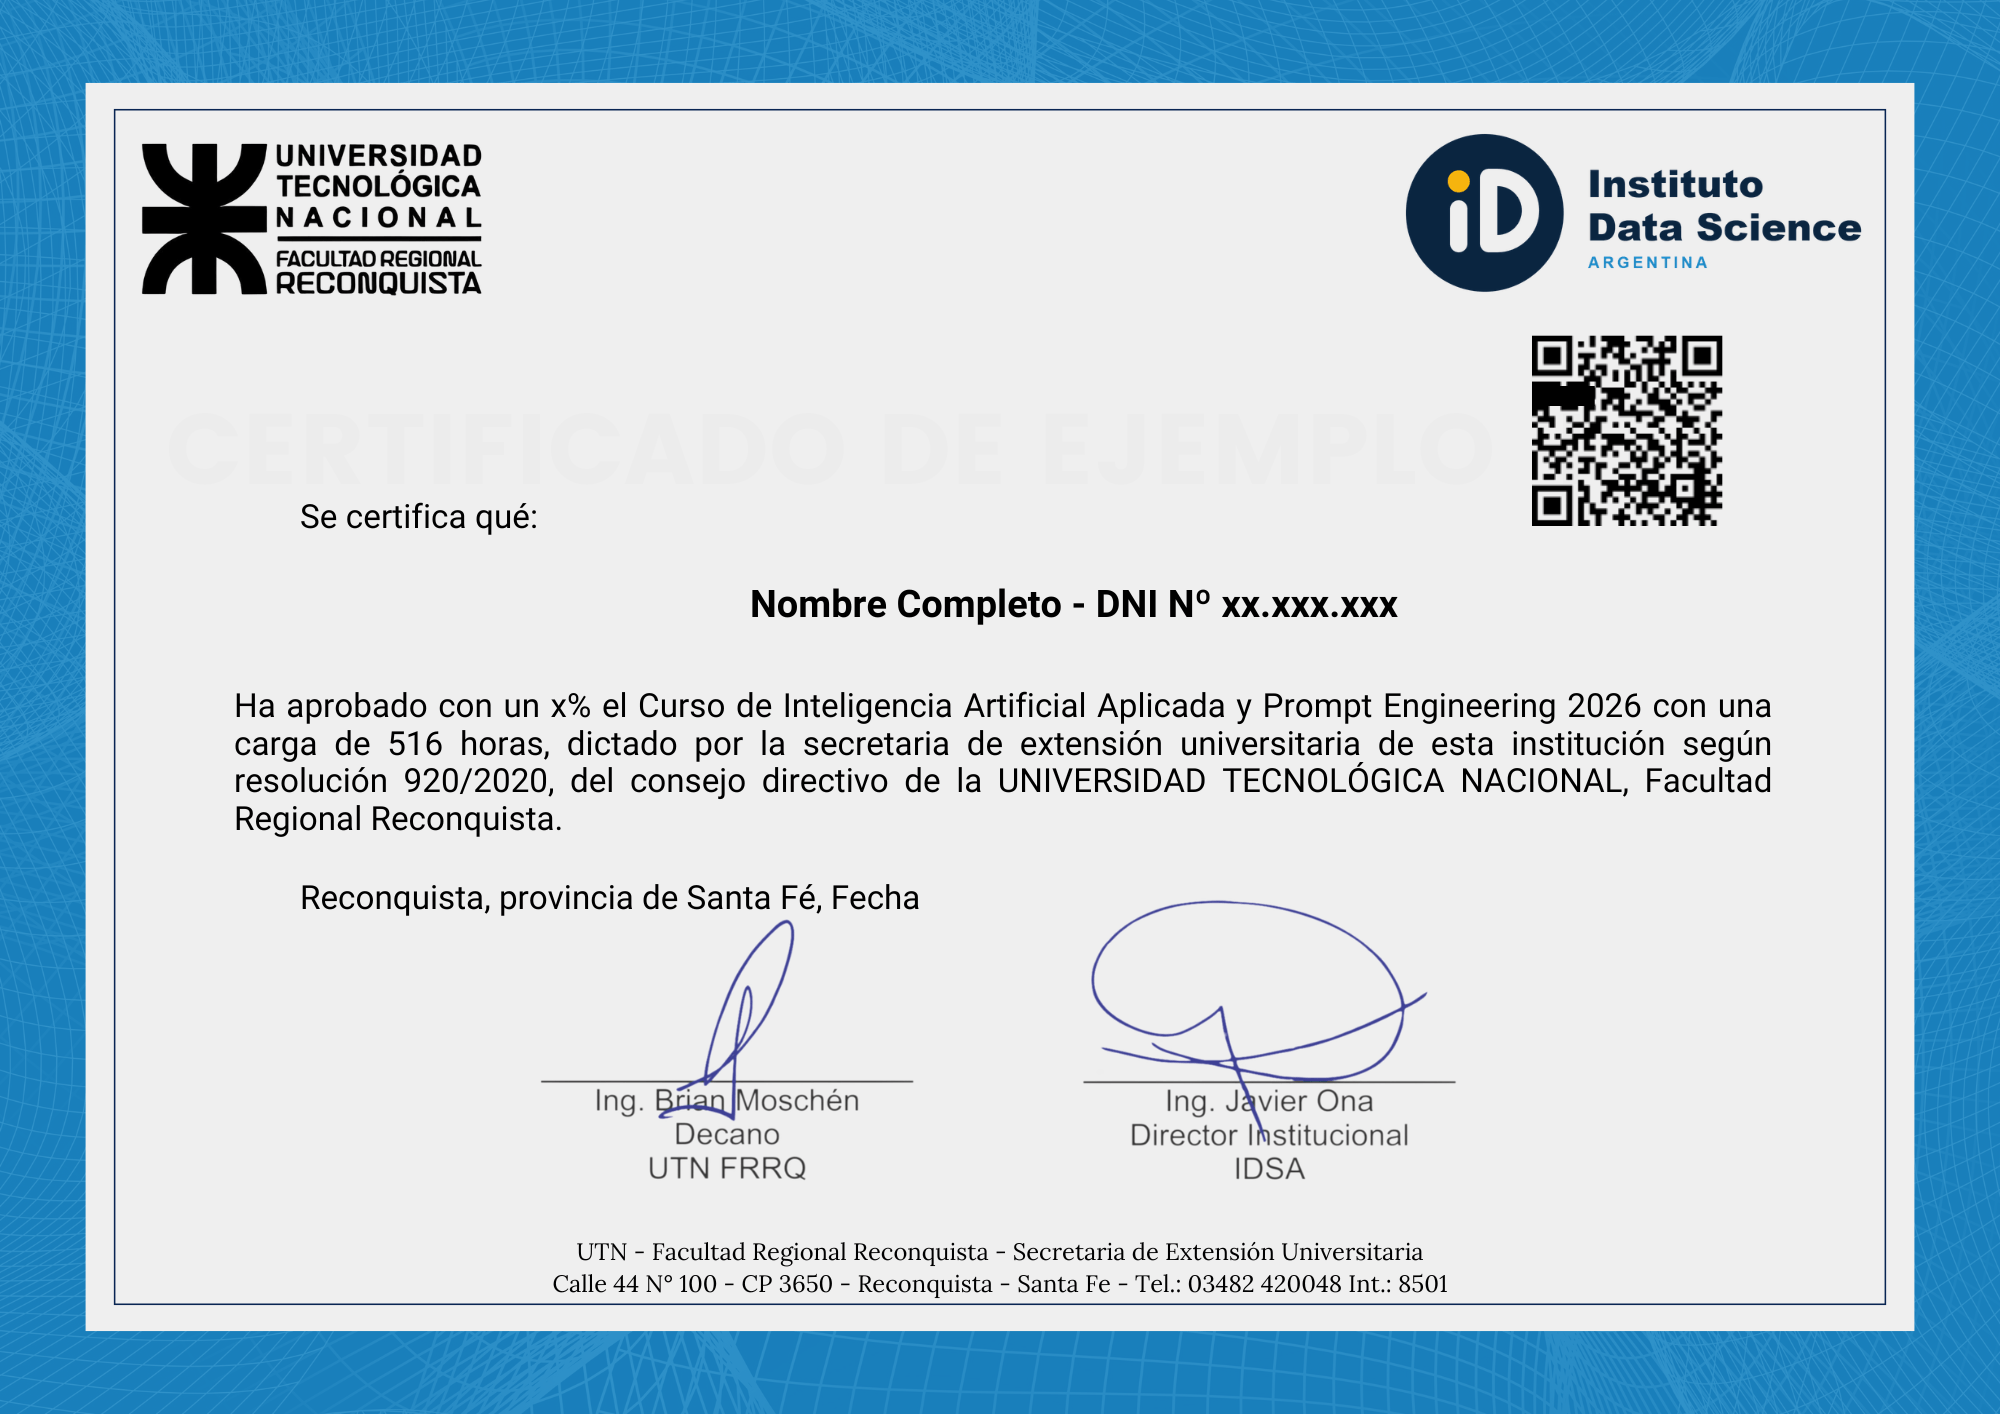
Qué incluye el certificado
- Doble firma: Director de IDSA + Decano UTN FRRQ
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
Del prompt al sistema en producción
10 unidades, 30 horas, con proyecto integrador end-to-end. RAG, LoRA y despliegue optimizado.