Diplomatura en ML Engineer
Del notebook al pipeline desplegado. SQL y pipelines de datos, machine learning, MLOps, cloud y Kubernetes: sistemas de ML en producción con monitoreo, orquestación y escalabilidad. Certificación IDSA + UTN.
Sobre esta Diplomatura
La Diplomatura en ML Engineer forma profesionales capaces de llevar modelos de machine learning a producción real: pipelines reproducibles, serving escalable, monitoreo de drift, CI/CD y un sistema RAG desplegado como servicio. Es el perfil de infraestructura de ML del ecosistema IDSA.
El foco es la confiabilidad, no la experimentación. El ML Engineer no descubre modelos: los lleva de un notebook a un sistema que responde en milisegundos, se monitorea y se reentrena. Por eso el trayecto parte de los datos (SQL y pipelines), pasa por el modelado y llega a MLOps, cloud, Kubernetes y un RAG en producción.
Es uno de los roles mejor pagos del mercado data: según el Observatorio IDSA 2026, la mediana es de $1,7M (Junior), $2,6M (Semisenior) y $3,8M (Senior) ARS brutos mensuales, la tercera entre los seis roles relevados. Toda empresa que use ML en producción necesita ML Engineers.
Se apoya en el tutor virtual 24/7, en notebooks ejecutables en el navegador y en repositorios de referencia con manifiestos de Kubernetes listos para usar.
Cinco etapas hacia la producción de ML
Cada etapa suma una capa: de los fundamentos a los datos y al modelado, de los pipelines a la nube, y de la nube a la plataforma de ML en producción.
Nivelación matemática, Python y SQL. Las competencias mínimas para trabajar con datos y construir sistemas de ML.
Entrenamiento, validación e interpretación de modelos con scikit-learn, XGBoost y SHAP, y el ciclo de vida de un modelo: MLflow, DVC, FastAPI, Docker, monitoreo de drift y reentrenamiento.
Pipelines de datos en capas con orquestación, calidad y observabilidad, y despliegue en la nube: AWS, contenedores, CI/CD, servicios gestionados, FinOps y seguridad.
Plataforma MLOps sobre Kubernetes (KServe, Feast, Kubeflow, Evidently, Prometheus) y sistemas RAG: búsqueda vectorial, evaluación, mitigación de alucinaciones y despliegue como servicio.
Un sistema de ML completo desplegado: pipeline reproducible, serving, monitoreo, reentrenamiento automático y plan de escalabilidad.
Qué vas a aprender, curso por curso
Cada curso se cursa y certifica de forma individual. Al aprobar los nueve más el trabajo final, se emite el diploma de la diplomatura.
Nivelación Matemática para Data Science
Derivadas, vectores, matrices, probabilidad y notación matemática aplicada a Machine Learning. Sin matemática abstracta: todo orientado a ciencia de datos, con Python y casos reales.
Python para Data Science
Del primer script al primer dashboard. Pandas, NumPy, Matplotlib y Dash. Los 4 verbos fundamentales de Pandas y la conexión con el análisis de negocio.
SQL para Data Science
El lenguaje universal de los datos. SELECT, JOINs, agregaciones, subconsultas y window functions. Análisis de cohortes, retención y funnels sobre datasets reales.
Machine Learning Supervisado y No Supervisado
Entrená, validá y explicá modelos de ML con scikit-learn, XGBoost y LightGBM: regresión logística, árboles, ensambles, validación cruzada, umbral de decisión, SHAP y clustering, sobre un caso de riesgo de mora.
MLOps y Regresión
Del notebook al pipeline productivo. scikit-learn, FastAPI, Docker, monitoreo de drift y reentrenamiento automático. Proyecto integrador acumulativo.
Data Engineering Fundamentals
Del CSV crudo al pipeline observable: ingesta batch, capas bronze/silver/gold, orquestación con DAGs (construís tu propio orquestador), validaciones de calidad y observabilidad, sobre un caso real de Fintora.
Cloud para ML y Datos
Cloud aplicado a datos y ML: AWS esencial (S3, IAM, Lambda, SageMaker), contenedores y CI/CD con GitHub Actions, FinOps y seguridad, con los equivalentes en GCP y Azure.
MLOps Avanzado: Kubernetes y Feature Store
Plataforma MLOps completa sobre Kubernetes: serving con KServe, Feature Store con Feast, MLflow, Kubeflow Pipelines y monitoreo de drift con Evidently y Prometheus.
RAG Fundamentos
Retrieval-Augmented Generation. Búsqueda vectorial desde cero, evaluación con métricas objetivas, mitigación de alucinaciones y despliegue en producción.
Tres orientaciones en ingeniería de ML
La orientación se define por el trabajo final y el énfasis en cada componente del stack de producción.
ML Engineer
Lleva modelos a producción: pipelines reproducibles, serving, monitoreo y reentrenamiento automático.
MLOps Engineer
Construye la plataforma de ML: infraestructura, orquestación, observabilidad y escalabilidad.
ML Data Engineer
Construye los pipelines que alimentan a los modelos: ingesta, capas de datos, calidad y observabilidad.
Los perfiles son orientativos. El alumno construye su especialización con el trabajo final y los proyectos del Laboratorio de Datos.
Pipeline productivo real
Un sistema de ML completo desplegado: ingesta y preparación de datos, entrenamiento reproducible, serving escalable, monitoreo con alertas, reentrenamiento automático y plan de escalabilidad. Incluye documentación técnica y defensa ante comité.
- Duración: 17 horas distribuidas en 4-6 semanas
- Tutoría personalizada durante todo el desarrollo
- Defensa oral ante comité técnico
- Publicación en el Laboratorio de Datos del Instituto
Doble aval universitario
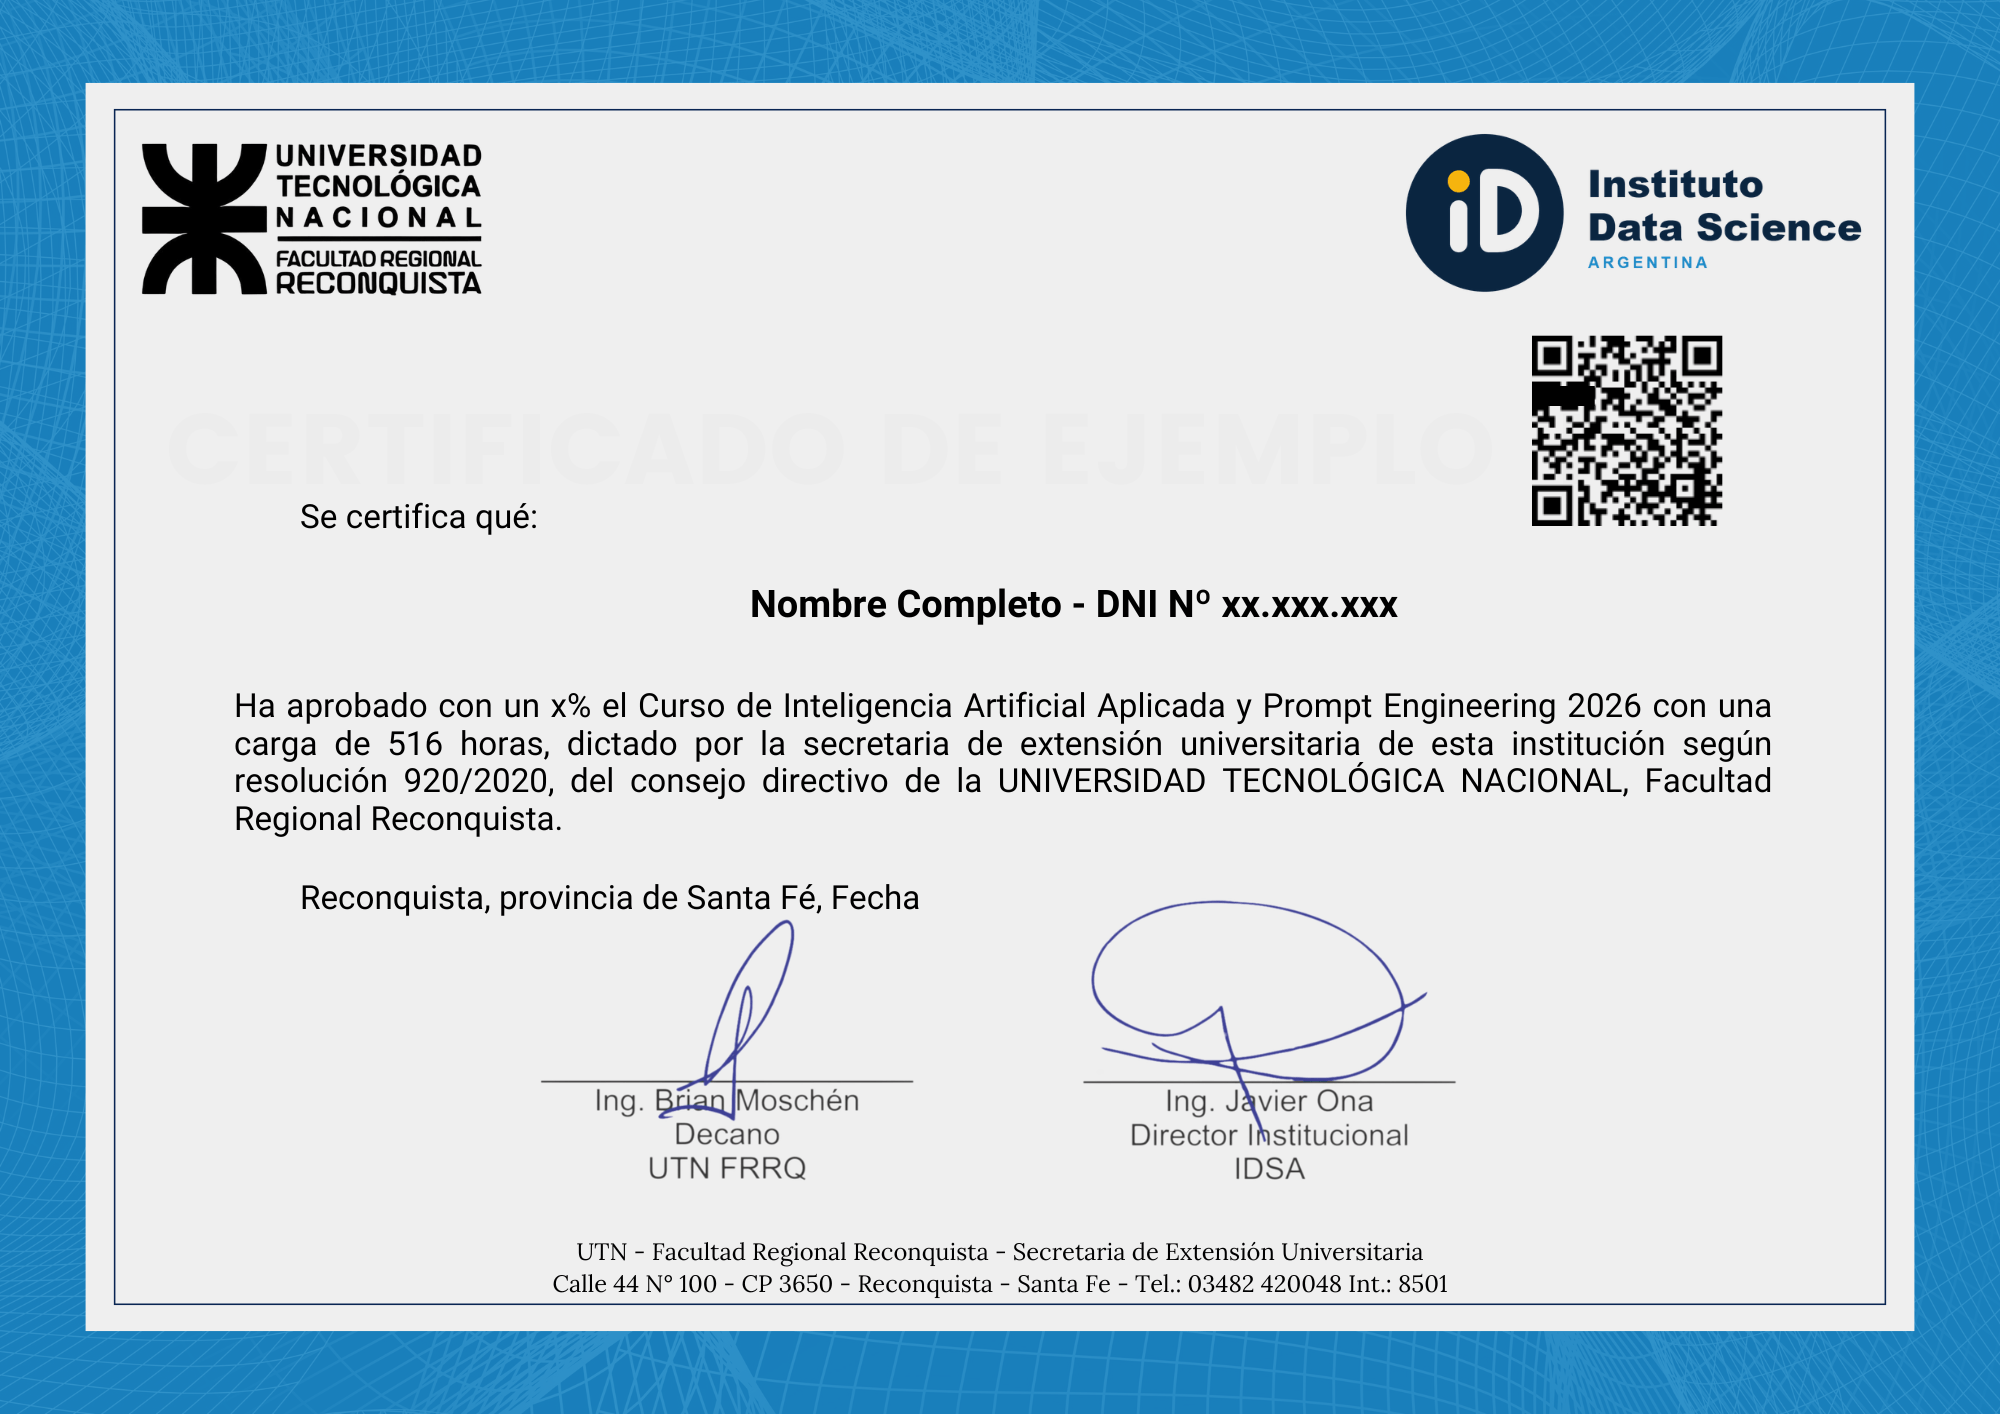
Certificación IDSA + UTN con resolución oficial y verificación digital de cada curso aprobado.
Qué incluye la certificación
- Diploma final con doble firma (Director IDSA + Decano UTN FRRQ)
- Certificado por cada curso completado en el camino
- Resolución oficial 920/2020 UTN Facultad Regional Reconquista
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Acreditación progresiva: cada curso completado ya queda certificado
Los certificados se emiten al aprobar los quizzes y trabajos prácticos de cada curso.
¿Diplomatura o cursos sueltos?
| Aspecto | Curso suelto | Diplomatura completa |
|---|---|---|
| Duración por unidad | 15-30h por curso | 267h totales |
| Certificación | IDSA + UTN por curso | IDSA + UTN por curso + diploma final |
| Trabajo final aplicado | — | ✓ Obligatorio |
| Publicación en Laboratorio | — | ✓ Elegible |
| Stack completo de ML Eng | Parcial | ✓ SQL + pipelines + ML + MLOps + Cloud + K8s |
| Pipelines de datos para ML | Parcial | ✓ SQL + Data Engineering Fundamentals |
Dudas sobre la Diplomatura
¿Necesito experiencia previa en ingeniería o DevOps?
No. La trayectoria arranca desde la nivelación matemática, Python y SQL. Solo se requiere matemática de secundaria, ganas de aprender y comodidad con herramientas técnicas.
¿Qué herramientas voy a usar?
Python (scikit-learn, XGBoost, SHAP), SQL (SQLite, DuckDB, PostgreSQL), MLflow, DVC, FastAPI, Docker, Airflow o Prefect, Kubernetes, KServe, Kubeflow, Feast, Evidently, Prometheus, Grafana, AWS (S3, IAM, Lambda, SageMaker), GitHub Actions, Chroma, FAISS, LangChain y Hugging Face. Los notebooks corren en Google Colab y JupyterLite desde el navegador.
¿Necesito instalar algo en mi computadora?
Casi nada. Los notebooks corren en Google Colab o JupyterLite y, para las unidades de Docker, se usan entornos en la nube como Google Cloud Shell o Play with Docker. En MLOps Avanzado, Kubernetes se practica con kind, minikube o clusters gestionados gratuitos de GCP, AWS o Azure; si preferís no armar un clúster, podés seguir el curso a nivel conceptual validando manifiestos.
¿Cuánto tiempo lleva completarla?
A 10 horas semanales: aproximadamente 27 semanas (poco más de 6 meses). A 6 horas semanales: 10-11 meses. El ritmo lo definís vos.
¿Cómo se cursan los cursos de la diplomatura?
Cada curso se cursa y se paga de forma individual. Podés comprarlos a medida que avanzás. Al aprobar los 9 cursos más el trabajo final, se emite el diploma de la diplomatura.
¿Cuál es la diferencia con la Diplomatura en AI Engineer?
AI Engineer se enfoca en construir sistemas generativos sobre deep learning: RAG, fine-tuning y agentes. ML Engineer se enfoca en los datos y en la producción: SQL, pipelines, MLOps, cloud, Kubernetes y feature stores. Comparten Nivelación, Python, MLOps y Regresión y RAG Fundamentos, pero el foco final es distinto: uno construye, el otro opera.
¿Qué industrias demandan este perfil?
Bancos, fintech, retail, telecomunicaciones, salud, industria y cualquier organización que tenga modelos de ML en producción. También empresas de tecnología, consultoras y startups de IA.
¿Qué puedo cursar después?
Es una diplomatura terminal del ecosistema IDSA en el área de producción de ML. Al completar cualquier Diplomatura IDSA tenés acceso directo a los cursos del Frontier Program; en otro caso se rinde un examen de admisión técnico. Para esos cursos se recomienda además estadística avanzada y machine learning: esta diplomatura incluye Machine Learning, y Estadística Avanzada se cursa por separado.
Llevá modelos a producción a escala
267 horas con foco en datos, machine learning, MLOps, cloud y Kubernetes. Trabajo final de pipeline productivo y doble certificación IDSA + UTN.