Optimización de Recuperación (RAG Avanzado)
Dominá la recuperación híbrida (BM25 + Embeddings), implementá técnicas avanzadas como HyDE y MMR, aplicá fine-tuning con losses contrastivas y escalá con índices ANN (HNSW, IVF). Optimizá latencia y precisión.
def hybrid_search(query, alpha):
lex = bm25.rank(query)
sem = embedding.rank(query)
hybrid = alpha*lex + (1–alpha)*sem
return mmr(hybrid, lambda=0.7)
Lo que lograrás al completar el curso
Cada objetivo es verificable mediante entregables y defensa conversacional. Aprenderás a optimizar la recuperación léxica y semántica para sistemas RAG de producción.
Diseñar e implementar pipelines de recuperación optimizados combinando métodos léxicos (BM25) y semánticos (embeddings)
Aplicar técnicas de aumento (HyDE), diversificación (MMR) y fine-tuning de representaciones con losses contrastivas
Evaluar críticamente la calidad con métricas (Recall@k, MRR, NDCG@k) y optimizar latencia con ANN (HNSW, IVF)
Construir un ranker híbrido BM25 + embeddings y optimizar el peso de fusión alpha
Implementar BM25 desde cero y comparar métricas de similitud entre embeddings
Mitigar riesgos de alucinación en HyDE mediante umbrales de confianza
Prevenir catastrophic forgetting durante el fine-tuning de embeddings
10 unidades · Álgebra, métricas e híbridos
Progresión estructurada: de los fundamentos matemáticos de la recuperación a la implementación de índices escalados y su conexión con modelos generativos.
- Recordar normas, proyecciones y producto punto
- Comprender la desigualdad de Cauchy-Schwarz
- Derivar e implementar BM25 desde cero
- Optimizar parámetros k1 y b
- Calcular Recall@k, MRR, NDCG@k, Precision/Recall
- Interpretar curvas de ganancia acumulada
- Comparar métricas (coseno, producto punto, distancia euclídea)
- Evaluar impacto de la normalización
- Implementar ranker híbrido
- Optimizar el peso alpha en fusión
- Generar documentos sintéticos con LLM
- Mitigar riesgos de alucinación con umbrales
- Derivar la función de diversidad
- Ajustar lambda según contexto
- Aplicar losses contrastivas (triplet, InfoNCE)
- Implementar hard negative mining
- Prevenir catastrophic forgetting
- Implementar ANN con índices HNSW, IVF
- Evaluar trade-off velocidad-precisión
- Conectar recuperación con muestreo estocástico (difusión)
- Sintetizar el aprendizaje del curso
Diseñado para profesionales que practican
100% asincrónica, autogestionada, on-demand. Contenido en Moodle, tutor RAG 24/7, quizzes y entregables verificables con defensa conversacional.
Tutor RAG 24/7
Un asistente RAG entrenado sobre el contenido del curso responde tus dudas. Evalúa tu conocimiento mediante defensa conversacional.
- Respuestas con fuentes citadas
- Defensa conversacional
- Contexto del curso completo
Contenido en Moodle
Lecciones estructuradas y referenciadas en texto. Sin videos interminables: leé, consultá y avanzá a tu ritmo.
- Plataforma Moodle
- Búsqueda instantánea
- Ritmo personal
Notebooks en Google Colab
Notebooks ejecutables con código real. No pseudocódigo: cada técnica de recuperación se implementa y ejecuta.
- Ejecución sin configuración
- Código paso a paso
- GPU disponible en Colab
Quizzes y entregables
Cada unidad tiene quizzes y entregables con verificación automática: tests sobre tu código, métricas de evaluación mínimas, etc.
- Corrección automática
- Criterios objetivos
- Feedback inmediato
De la teoría a la recuperación a escala
Ciclo estructurado que se repite en las 10 unidades para consolidar competencias verificables.
Recuperar
BM25 léxico y embeddings densos.
Híbrido
Fusión de scores y MMR para diversidad.
Optimizar
Fine-tuning de embeddings y HyDE.
Escalar
Índices ANN (HNSW, IVF) y latencia.
Herramientas que usarás
Sin fricción de configuración. Todo se ejecuta en Google Colab.
Doble aval universitario, verificación digital
Al completar el curso recibís un certificado digital con doble aval: UTN Facultad Regional Reconquista e Instituto Data Science Argentina.
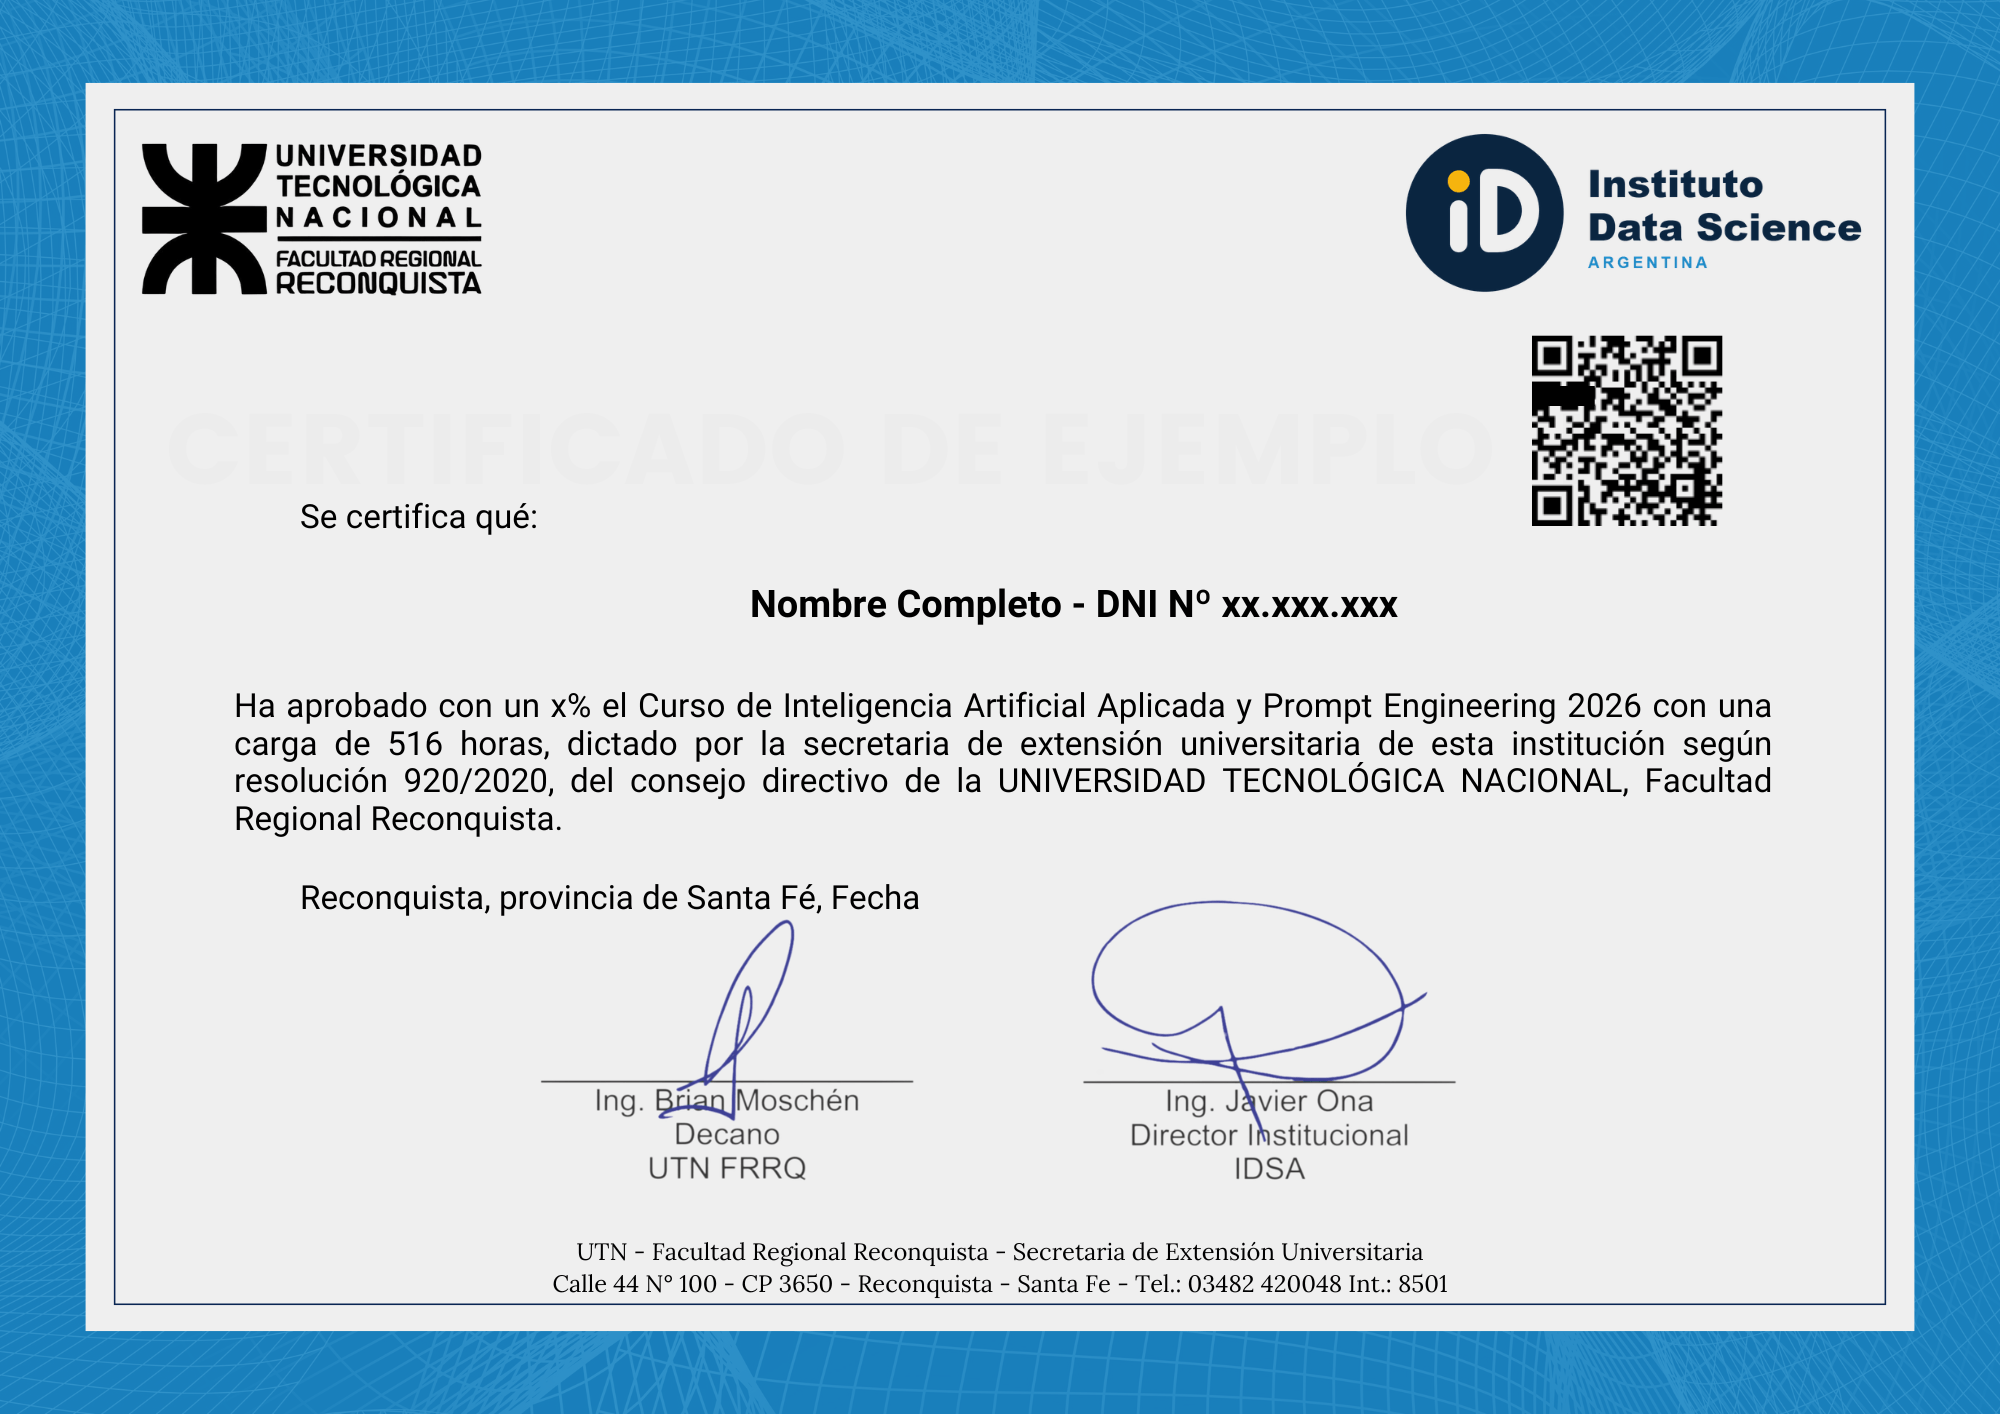
Qué incluye el certificado
- Doble firma: Decano UTN FRRQ + Director IDSA
- Resolución oficial: 920/2020 UTN Facultad Regional Reconquista
- Datos personalizados: nombre, DNI, curso, carga horaria y calificación
- Código QR de verificación digital
- Copia automática a la Facultad para registro oficial
- Emisión por curso: no esperás al final del trayecto
Se emite al aprobar los quizzes del curso y los trabajos prácticos con estado aprobado.
Resolvemos tus dudas
De la recuperación básica a la híbrida y escalable
10 unidades, 30 horas, verificable y aplicable. Dominá la fusión léxica y semántica para RAG de producción.